思路和代码来自 B 站 UP 主 https://space.bilibili.com/1822828582 的课程。
Softmax 简介 Softmax 的作用是将输入向量映射到一个所有元素值域在 [0, 1] 之间、且总和为 1 的概率分布 上。
计算公式 给定一个输入向量 $\mathbf{z} = [z_1, z_2, …, z_n] \in \mathbb{R}^n$,Softmax 的原始公式定义如下:
注意 :为了避免指数爆炸(Numerical Overflow),在实现时通常会将所有输入减去输入向量中的最大值。
CPU 实现 CPU 版本是最基础的串行实现,每个大循环处理一行数据,主要分三个步骤:
求最大值 :遍历当前行,找到最大值 maxval。计算指数和求和 :对每一项减去最大值后求指数 expf(),同时累加求和 sum,结果保存在输出数组中。归一化 :对输出数组中的每一项除以 sum。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
void softmax_forward_cpu (float *out, const float *inp, int N, int C) for (int i = 0 ; i < N; i++) { const float *inp_row = inp + i * C; float *out_row = out + i * C; float maxval = -INFINITY; for (int j = 0 ; j < C; j++) { if (inp_row[j] > maxval) { maxval = inp_row[j]; } } float sum = 0.f ; for (int j = 0 ; j < C; j++) { out_row[j] = expf (inp_row[j] - maxval); sum += out_row[j]; } float norm = 1.f / sum; for (int j = 0 ; j < C; j++) { out_row[j] *= norm; } } }
可以看到它是完全串行 的,循环中存在依赖链。
CUDA Kernel 1:朴素版本 最大的变化是每一行之间的操作变成并行 的了。通过 if (i < N) 判断,一共有 N 个线程,每个线程负责处理一行。内存使用 cudaMalloc 申请,位于显存 (Global Memory) 中。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
__global__ void softmax_forward_kernel1 (float *out, const float *inp, int N, int C) { int i = blockIdx.x * blockDim.x + threadIdx.x; if (i < N) { const float *inp_row = inp + i * C; float *out_row = out + i * C; float maxval = -INFINITY; for (int j = 0 ; j < C; j++) { if (inp_row[j] > maxval) { maxval = inp_row[j]; } } float sum = 0.f ; for (int j = 0 ; j < C; j++) { out_row[j] = expf (inp_row[j] - maxval); sum += out_row[j]; } for (int j = 0 ; j < C; j++) { out_row[j] /= (float )sum; } } }
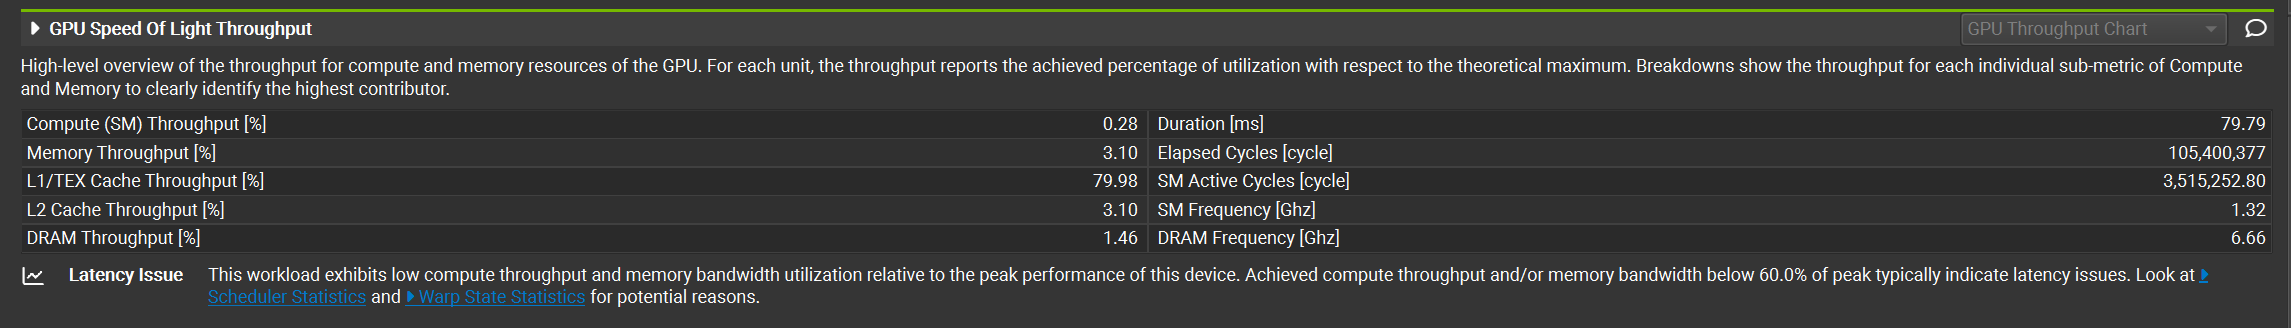
性能分析 在 Nsight Compute 中可以看到它的吞吐率非常低 。原因还是并行度太低了——只有不同行之间的并行,一行数据仍然使用一个线程串行处理。
CUDA Kernel 2:共享内存 + Block 规约 我们为每一行数据仅分配了一个线程进行处理,其中一个线程串行处理一行,这导致了在输入张量第二维度上的并行度严重不足。
优化思路有三个:
线程粗化 (Thread Coarsening) :每个线程处理多个元素。并行规约 (Parallel Reduction) :使用共享内存进行块内规约。使用片上共享内存 (Shared Memory) :减少对全局显存的访问。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
__global__ void softmax_forward_kernel2 (float *out, const float *inp, int N, int C) { extern __shared__ float shared[]; int idx = blockIdx.x; int tid = threadIdx.x; int block_size = blockDim.x; const float *x = inp + idx * C; float maxval = -INFINITY; for (int i = tid; i < C; i += block_size) { maxval = fmaxf (maxval, x[i]); } shared[tid] = maxval; __syncthreads(); for (int stride = block_size / 2 ; stride >= 1 ; stride /= 2 ) { __syncthreads(); if (tid < stride) { shared[tid] = fmaxf (shared[tid], shared[tid + stride]); } } __syncthreads(); float offset = shared[0 ]; for (int i = tid; i < C; i += block_size) { out[idx * C + i] = expf (x[i] - offset); } __syncthreads(); x = out + idx * C; float sumval = 0.0f ; for (int i = tid; i < C; i += block_size) { sumval += x[i]; } shared[tid] = sumval; __syncthreads(); for (int stride = block_size / 2 ; stride >= 1 ; stride /= 2 ) { __syncthreads(); if (tid < stride) { shared[tid] += shared[tid + stride]; } } __syncthreads(); float sum = shared[0 ]; for (int i = tid; i < C; i += block_size) { out[idx * C + i] = x[i] / sum; } }
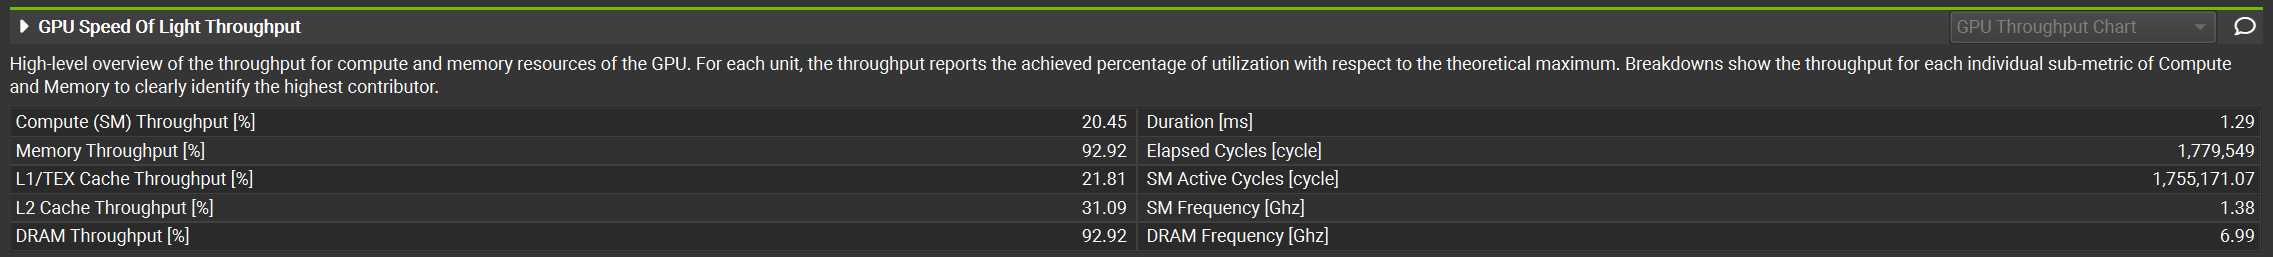
性能分析 在 Nsight Compute 中可以看到大幅提升 :
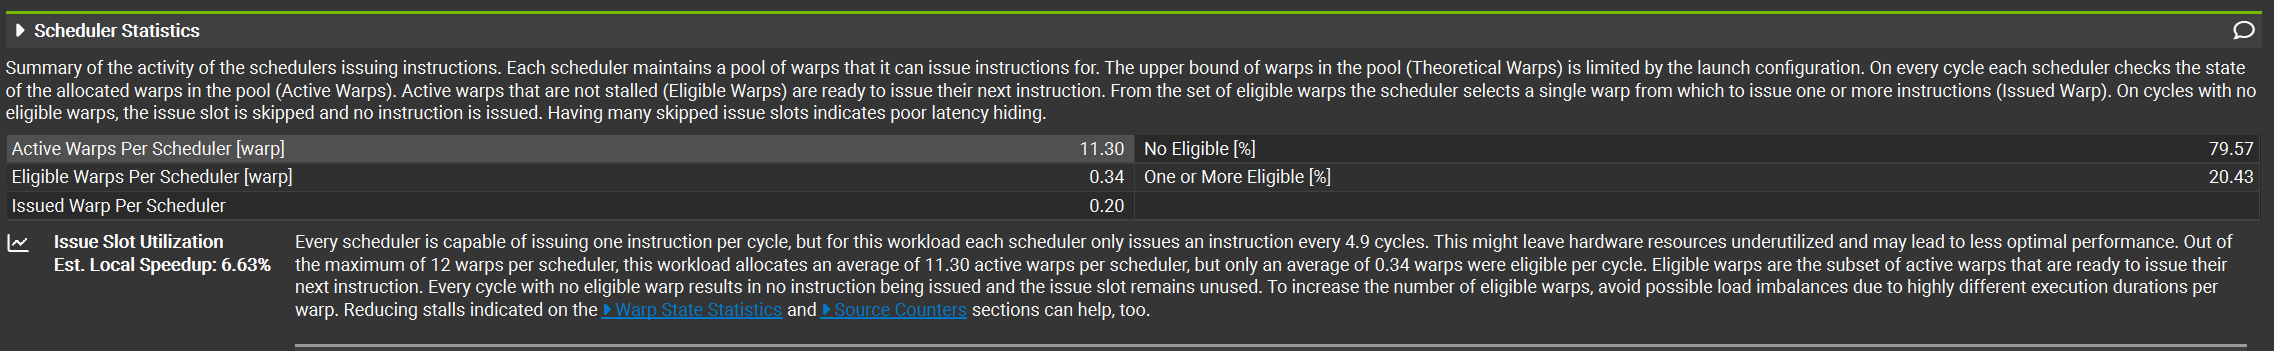
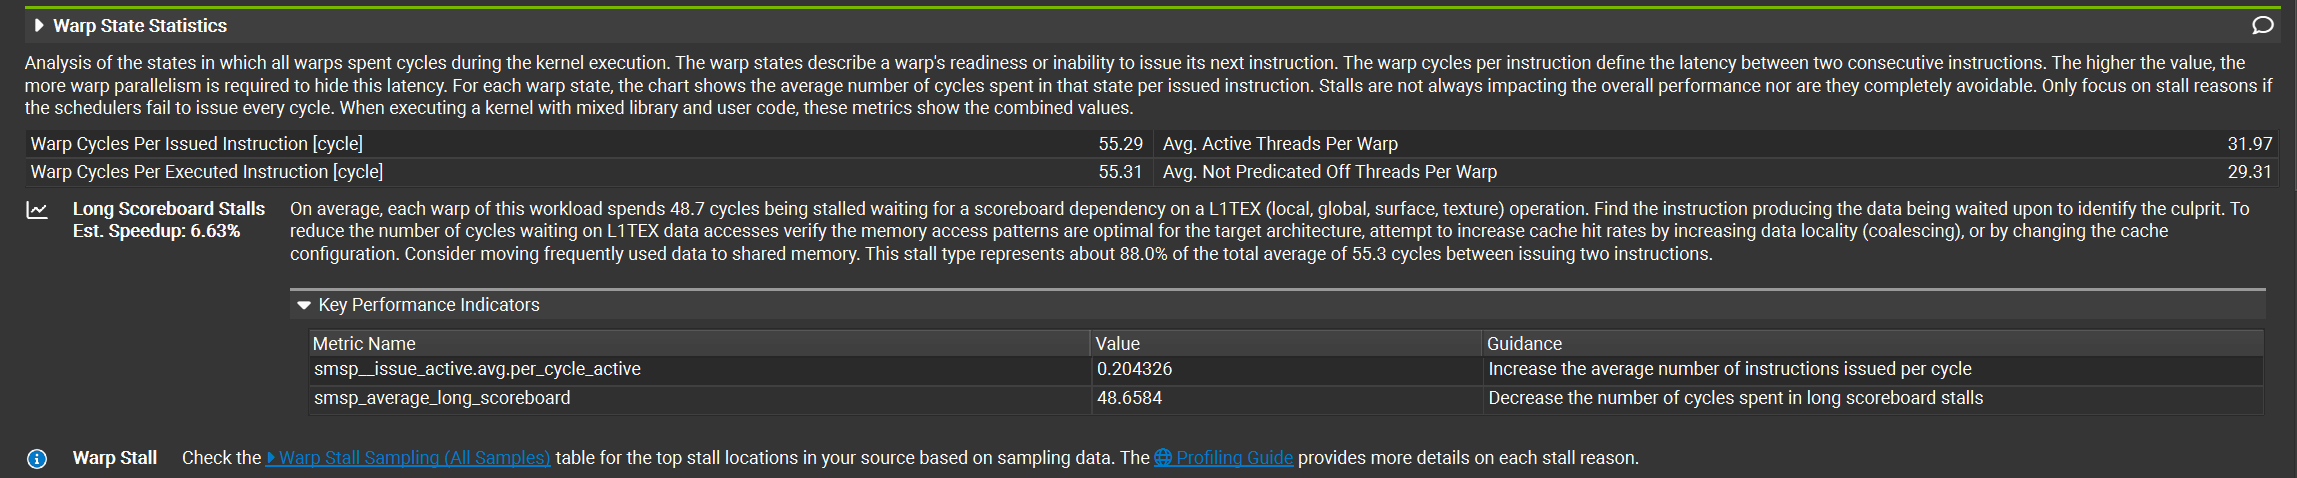
然而,下图显示每周期平均只有 0.34 个 warp 具备执行条件 ,这表明大部分 warp 都因各种原因被阻塞,无法及时获得执行机会。
原因分析:
“On average, each warp of this workload spends 48.7 cycles being stalled waiting for a scoreboard dependency on a L1TEX (local, global, surface, texture) operation . This stall type represents about 88.0% of the total average of 55.3 cycles between issuing two instructions.”
主要是全局显存的读取操作 造成的等待:
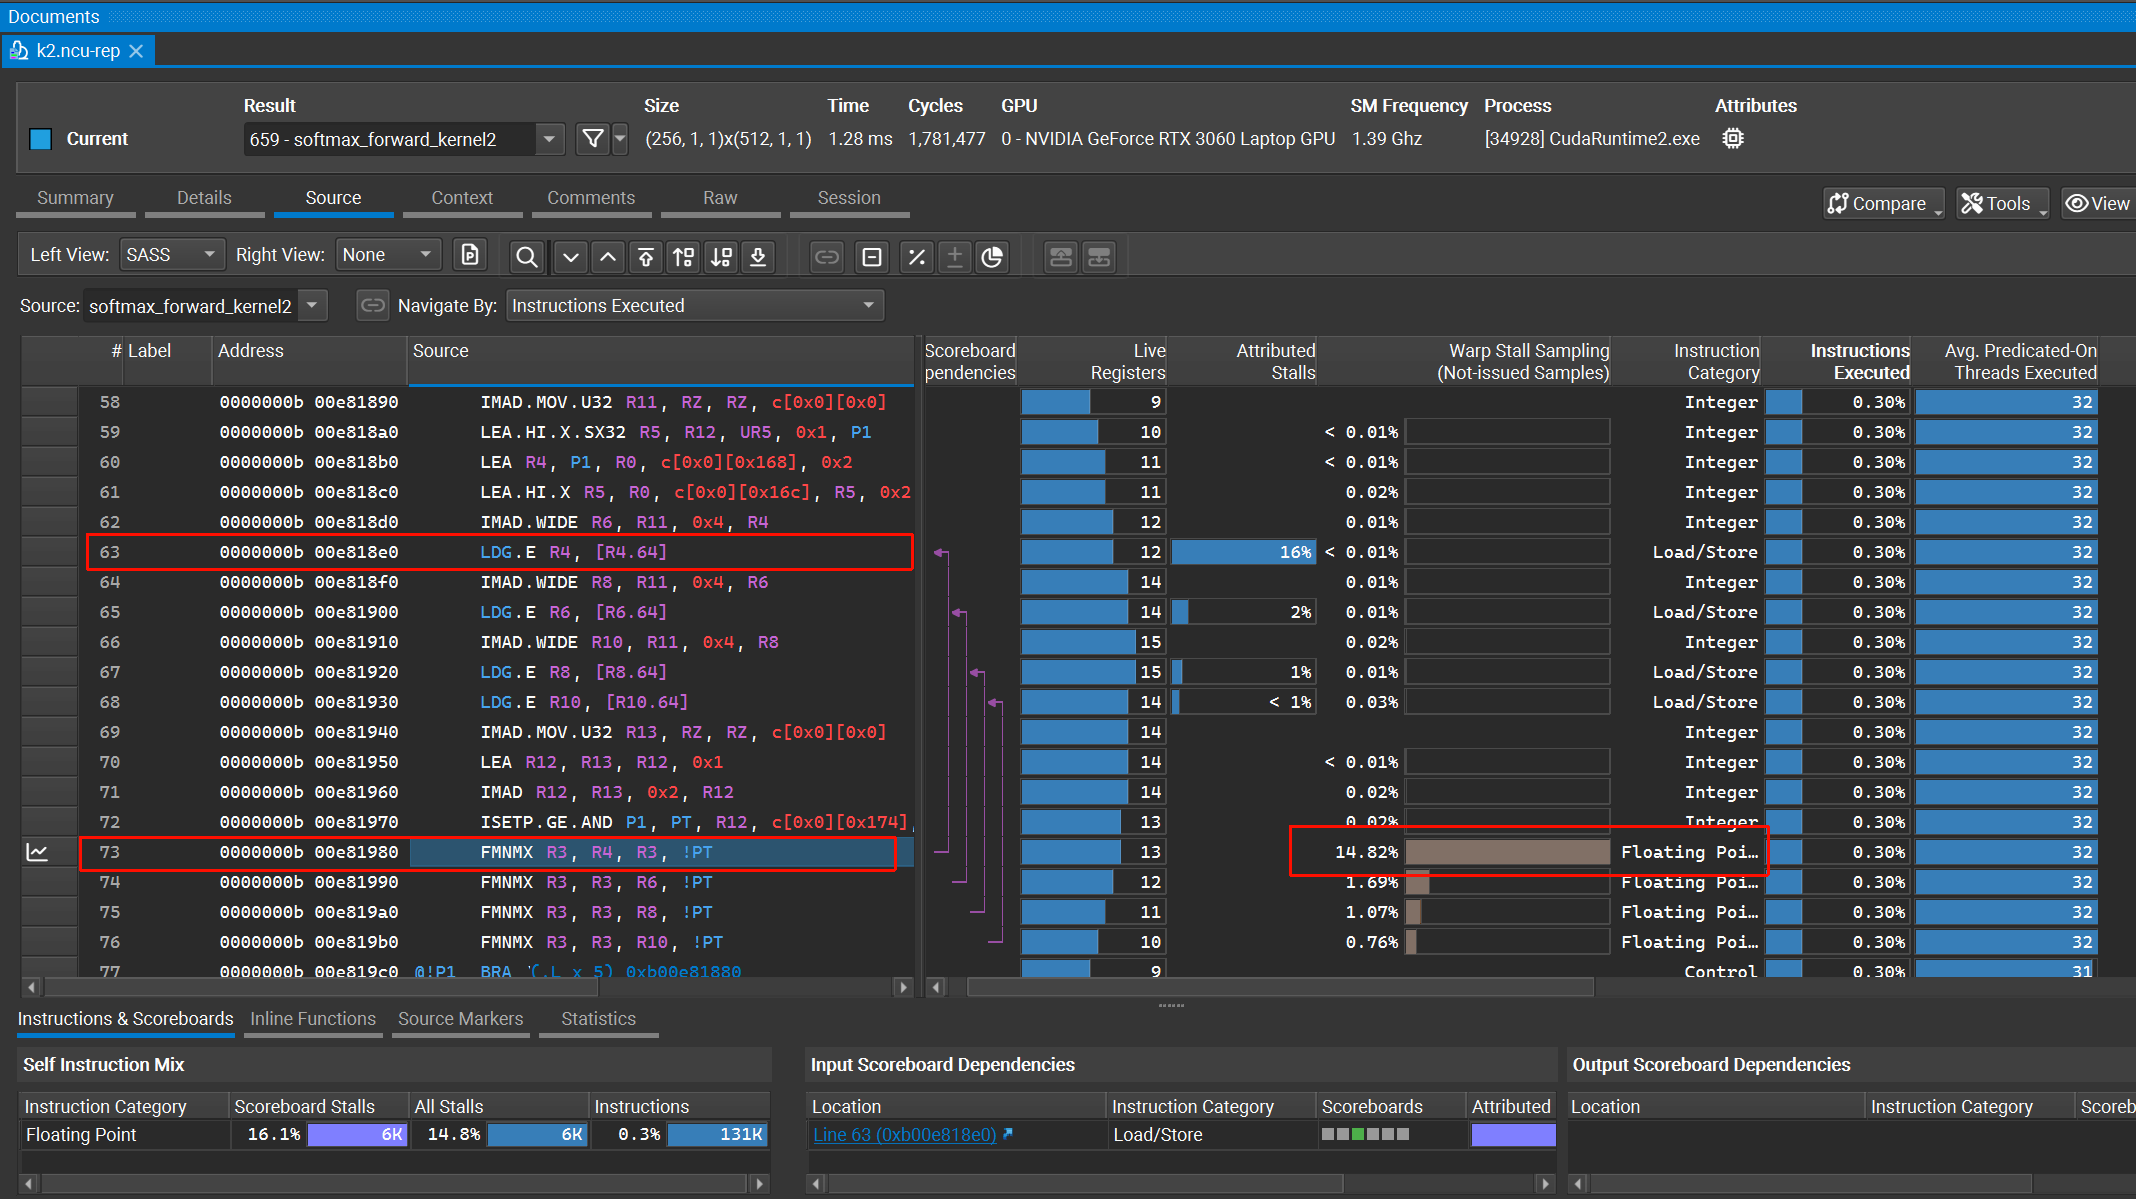
通过汇编指令分析:右侧的 Warp Stall Sampling 显示第 73 行有一个巨大的长条(14.82%)。这表示 GPU 的采样器发现有大量的 Warp 就停在这行指令上。
这行指令是比较 R4 和 R3 的值。它必须等 R4 准备好才能执行。而 R4 来自第 63 行 的 LDG.E R4, [R4.64]:
LDGL oaD G lobal,这是标准的全局内存读取指令。它对应 C++ 代码中的 x[i] 读取操作。
显存离核心很远,可能有几百个时钟周期的延迟 。
CUDA Kernel 3:Warp Shuffle(仅 32 线程) 核心改进是用 Warp Shuffle 指令 替换了共享内存通信。
但 Shuffle 指令只能在一个 Warp (32 线程) 内起作用,Thread Block 大小不能超过 32,这大大限制了线程块内部更大的并行潜力。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
__global__ void softmax_forward_kernel3 (float *out, const float *inp, int N, int C) { int idx = blockIdx.x; int tid = threadIdx.x; const float *x = inp + idx * C; float maxval = -INFINITY; for (int i = tid; i < C; i += blockDim.x) { maxval = fmaxf (maxval, x[i]); } maxval = warpReduceMax (maxval); float offset = __shfl_sync(0xFFFFFFFF , maxval, 0 ); for (int i = tid; i < C; i += blockDim.x) { out[idx * C + i] = expf (x[i] - offset); } x = out + idx * C; float sumval = 0.0f ; for (int i = tid; i < C; i += blockDim.x) { sumval += x[i]; } sumval = warpReduceSum (sumval); float sum = __shfl_sync(0xFFFFFFFF , sumval, 0 ); for (int i = tid; i < C; i += blockDim.x) { out[idx * C + i] = x[i] / sum; } }
CUDA Kernel 4:Warp Shuffle + 跨 Warp 规约 核心差异:
Kernel 2 :每个线程都把自己计算出来的局部最大值写入共享内存,然后进行规约。Kernel 4 :先使用 Warp Shuffle 在 Warp 内计算出最大值和求和结果,然后再将一个 Warp 的结果 写入共享内存进行跨 Warp 规约。
这减少了共享内存的使用,转而使用 Warp 内的寄存器通信 。共享内存只需要存储”每个 Warp 的结果”,而不是”每个线程的结果”。因为最大值(Max)和求和(Sum)各需要一份,所以共享内存大小为 2 * warpsPerBlock。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
__global__ void softmax_forward_kernel4 (float *out, const float *inp, int N, int C) { extern __shared__ float shared[]; int idx = blockIdx.x; int tid = threadIdx.x; int warpId = threadIdx.x / 32 ; int laneId = threadIdx.x % 32 ; int warpsPerBlock = blockDim.x / 32 ; float *maxvals = shared; float *sumvals = &shared[warpsPerBlock]; const float *x = inp + idx * C; float maxval = -INFINITY; for (int i = tid; i < C; i += blockDim.x) { maxval = fmaxf (maxval, x[i]); } maxval = warpReduceMax (maxval); if (laneId == 0 ) maxvals[warpId] = maxval; __syncthreads(); if (tid == 0 ) { float val = maxvals[tid]; for (int i = 1 ; i < warpsPerBlock; i++) { val = fmaxf (val, maxvals[i]); } maxvals[0 ] = val; } __syncthreads(); float offset = maxvals[0 ]; for (int i = tid; i < C; i += blockDim.x) { out[idx * C + i] = expf (x[i] - offset); } x = out + idx * C; float sumval = 0.0f ; for (int i = tid; i < C; i += blockDim.x) { sumval += x[i]; } sumval = warpReduceSum (sumval); if (laneId == 0 ) sumvals[warpId] = sumval; __syncthreads(); if (tid == 0 ) { float val = sumvals[tid]; for (int i = 1 ; i < warpsPerBlock; ++i) { val += sumvals[i]; } sumvals[0 ] = val; } __syncthreads(); float sum = sumvals[0 ]; for (int i = tid; i < C; i += blockDim.x) { out[idx * C + i] = x[i] / sum; } }
整体性能测试 测试环境:N=256, C=65536, blockSize=512
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
========== CPU Baseline ========== CPU time: 232.26 ms ========== GPU Kernels ========== --- Kernel 1: Naive (one thread per row) --- Average: 65.68 ms Speedup vs CPU: 3.54x Correctness: PASS --- Kernel 2: Shared memory + block reduction --- Average: 1.67 ms Speedup vs CPU: 138.91x Speedup vs Kernel1: 39.28x Correctness: PASS --- Kernel 3: Warp shuffle (32 threads only) --- Average: 3.37 ms Speedup vs CPU: 68.88x Speedup vs Kernel1: 19.48x Correctness: PASS --- Kernel 4: Warp shuffle + inter-warp reduction --- Average: 1.32 ms Speedup vs CPU: 175.87x Speedup vs Kernel1: 49.73x Correctness: PASS ========== Performance Summary ========== CPU: 232.26 ms Kernel 1: 65.68 ms (speedup: 3.54x) Kernel 2: 1.67 ms (speedup: 138.91x) Kernel 3: 3.37 ms (speedup: 68.88x) Kernel 4: 1.32 ms (speedup: 175.87x) Fastest: Kernel 4 (1.32 ms)
总结
Kernel
优化手段
加速比 (vs CPU)
Kernel 1
朴素并行(行间并行)
3.54x
Kernel 2
共享内存 + Block 规约
138.91x
Kernel 3
Warp Shuffle(仅 32 线程)
68.88x
Kernel 4
Warp Shuffle + 跨 Warp 规约
175.87x
Kernel 4 通过结合 Warp Shuffle 的低延迟通信和跨 Warp 规约,取得了最佳性能。