L1 Cache 组相联度探测
这篇博客主要介绍一种在已知 L1 Data Cache 大小的情况下,探测其 组相联度 (Associativity) 的方法。
背景
其实组相联度通常不需要”探测”,因为现代 CPU 为了支持 VIPT (Virtually Indexed, Physically Tagged),通常遵循以下公式:
为了最大化 Cache 容量和 Set 数量,设计时通常取等号。
例如,Golden Cove 的 P-Core L1 Data Cache 大小为 48KB。根据公式 $48KB / \text{Ways} = 4KB$,很明显它的组相联度就是 12 路。
关于 VIPT 的详细解释,可以参考我的另一篇博客:Virtually Indexed, Physically Tagged
那么,有没有一种不通过计算,而是通过编写测试代码的方式来探测验证这一结论呢?
答案是有的。这种方法虽然不能给出精确数值,但能通过性能特征推断出大致范围。
探测原理
测试方法的核心思想是:制造 Cache 冲突 (Conflict Miss)。
我们通过使用不同的步长 (Stride)(从 64B * 1 到 64B * 127)来访问内存。
- 每次读取一个 Cache Line (64字节) 的数据。
- 总通过读取一定的次数(例如 256 次)。
- 观察在不同步长下的读取带宽。
步长说明:
- Stride = 64:读取 64 字节,指针后移 64 字节,重复。
- Stride = 128:读取 64 字节,指针后移 128 字节,重复。
当步长恰好是某些数值(例如 Set 数量的倍数)时,我们的读取操作会集中映射到少数几个 Set 中。如果读取次数超过了这些 Set 能容纳的 Way 的数量(组相联度),就会发生频繁的冲突缺失,导致带宽大幅下降。
核心测试代码
代码来源:computer_enhance
汇编部分 (listing_0157_cache_indexing.asm)
1 | global ReadStrided_32x2 |
C++ 调用部分 (listing_0158_cache_indexing_main.cpp)
1 | int main(void) |
测试结果
| Stride (Bytes) | Bandwidth (GB/s) |
|---|---|
| 0 | 242.020422 |
| 64 | 242.020422 |
| 128 | 241.938242 |
| 192 | 241.979325 |
| 256 | 128.530373 |
| 320 | 241.487247 |
| 384 | 235.617765 |
| 448 | 241.651051 |
| 512 | 127.165469 |
| 576 | 239.901725 |
| 640 | 241.201125 |
| 704 | 241.979325 |
| 768 | 127.495414 |
| 832 | 236.360299 |
| 896 | 241.815076 |
| 960 | 241.897173 |
| 1024 | 125.607426 |
| 1088 | 236.281918 |
| 1152 | 230.771862 |
| 1216 | 241.979325 |
| 1280 | 126.758250 |
| 1344 | 241.897173 |
| 1408 | 241.897173 |
| 1472 | 241.692036 |
| 1536 | 126.219331 |
| 1600 | 240.265764 |
| 1664 | 237.780118 |
| 1728 | 227.747522 |
| 1792 | 123.613484 |
| 1856 | 200.763066 |
| 1920 | 192.309885 |
| 1984 | 186.691503 |
| 2048 | 117.847854 |
| 2112 | 178.127031 |
| 2176 | 175.581105 |
| 2240 | 173.401831 |
| 2304 | 118.514325 |
| 2368 | 170.824292 |
| 2432 | 169.685192 |
| 2496 | 169.021023 |
| 2560 | 116.109855 |
| 2624 | 168.044369 |
| 2688 | 167.373296 |
| 2752 | 166.941922 |
| 2816 | 114.828062 |
| 2880 | 166.008416 |
| 2944 | 165.219275 |
| 3008 | 164.418628 |
| 3072 | 111.129708 |
| 3136 | 163.700890 |
| 3200 | 163.288214 |
| 3264 | 163.138666 |
| 3328 | 112.542746 |
| 3392 | 163.138666 |
| 3456 | 162.506129 |
| 3520 | 162.450552 |
| 3584 | 111.494894 |
| 3648 | 161.511532 |
| 3712 | 160.222200 |
| 3776 | 160.330361 |
| 3840 | 110.741082 |
| 3904 | 158.846979 |
| 3968 | 159.916535 |
| 4032 | 159.130792 |
| 4096 | 97.677445 |
| 4160 | 159.451297 |
| 4224 | 159.469141 |
| 4288 | 159.683577 |
| 4352 | 110.338076 |
| 4416 | 159.237484 |
| 4480 | 159.006499 |
| 4544 | 158.935562 |
| 4608 | 109.785535 |
| 4672 | 159.095260 |
| 4736 | 159.059744 |
| 4800 | 159.451297 |
| 4864 | 110.457813 |
| 4928 | 159.576287 |
| 4992 | 159.469141 |
| 5056 | 159.808932 |
| 5120 | 108.523056 |
| 5184 | 159.683577 |
| 5248 | 159.255280 |
| 5312 | 159.719373 |
| 5376 | 110.612144 |
| 5440 | 160.006315 |
| 5504 | 159.344319 |
| 5568 | 159.791012 |
| 5632 | 110.150440 |
| 5696 | 159.880651 |
| 5760 | 165.584040 |
| 5824 | 159.898591 |
| 5888 | 110.758297 |
| 5952 | 163.870313 |
| 6016 | 159.504841 |
| 6080 | 159.916535 |
| 6144 | 105.713371 |
| 6208 | 159.683577 |
| 6272 | 159.540556 |
| 6336 | 159.880651 |
| 6400 | 111.051765 |
| 6464 | 159.522696 |
| 6528 | 159.433458 |
| 6592 | 159.576287 |
| 6656 | 110.355165 |
| 6720 | 159.612035 |
| 6784 | 176.014852 |
| 6848 | 159.791012 |
| 6912 | 111.086393 |
| 6976 | 159.988351 |
| 7040 | 159.612035 |
| 7104 | 159.773096 |
| 7168 | 108.854652 |
| 7232 | 159.558420 |
| 7296 | 163.063994 |
| 7360 | 159.647798 |
| 7424 | 111.017158 |
| 7488 | 159.862715 |
| 7552 | 159.701473 |
| 7616 | 159.952435 |
| 7680 | 110.526351 |
| 7744 | 159.880651 |
| 7808 | 159.594159 |
| 7872 | 159.898591 |
| 7936 | 110.948010 |
| 8000 | 160.024284 |
| 8064 | 159.665686 |
| 8128 | 159.808932 |
结果分析
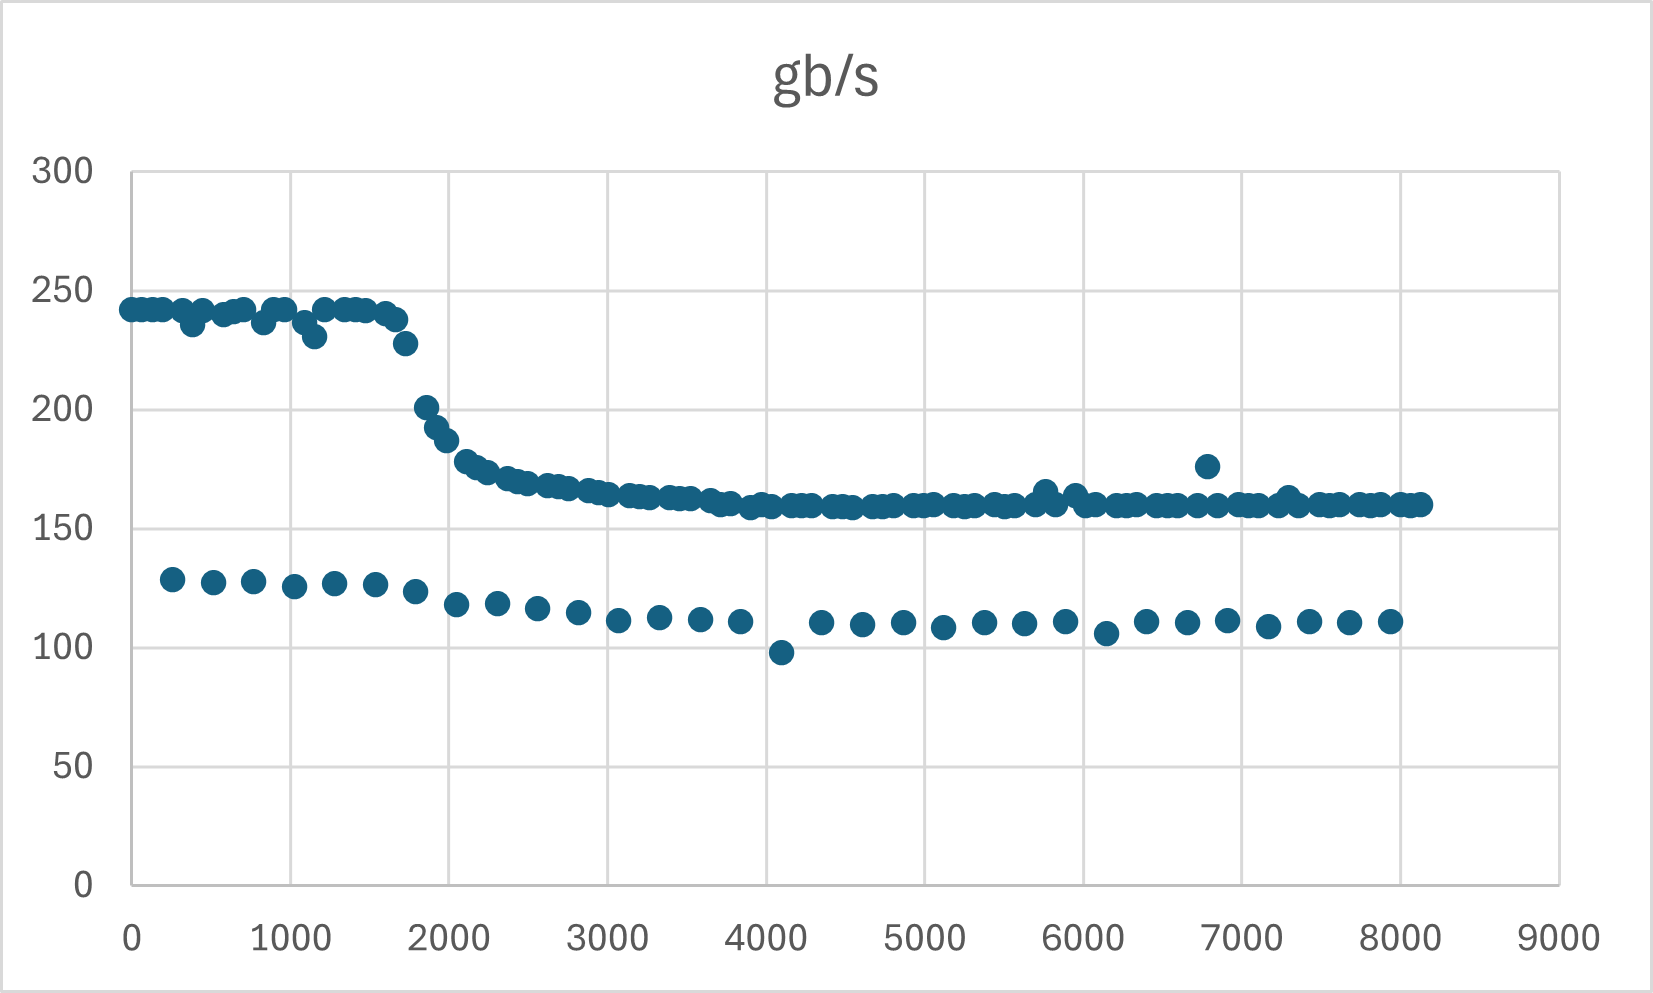
观察数据和图表,我们可以看到三个明显的现象:
- 特定倍数下降:带宽在步长为 256 的倍数时出现大幅下降(从 ~240GB/s 降至 ~120GB/s)。
- 最低谷底:带宽在步长为 4096 (64 * 64) 时达到最低点(~97GB/s)。
- 整体衰减:从步长 1600 左右开始,最大带宽开始呈现逐步下降趋势。
现象解释
1. 为什么是 256?(Hash 冲突)
当前 CPU (Golden Cove) 的 L1 Data Cache 为 48KB,12 路 (12-way) 组相联。
- Cache Line 大小 = 64B
- Set 总数 = $48KB / 64B / 12 = 64$ 个 Set。
当我们以 stride = 256B 访问时:
- $256B / 64B = 4$ 个 Cache Line。
- 这意味着我们每隔 4 个 Set 访问一次。
- 实际用到的 Set 数量 = $\frac{\text{总 Set 数}}{\text{GCD}(\text{总 Set 数, stride/64)}} = \frac{64}{\text{GCD}(64, 4)} = \frac{64}{4} = 16$ 个。
总共可用的 Entry 数量 = $16 \text{ (Sets)} \times 12 \text{ (Ways)} = 192$ 个。
而我们的程序循环读取了 256 次。
$256 > 192$,这必然导致缓存容量不足,旧的 Cache Line 被驱逐,发生 Capacity Miss / Conflict Miss,带宽减半。
2. 为什么 4096 最低?
当 Stride = 4096 时,$4096 / 64 = 64$。
- 每次偏移 64 个 Cache Line。
- $\text{GCD}(64, 64) = 64$。
- 实际用到的 Set 数量 = $64 / 64 = \mathbf{1}$ 个。
这意味着我们这 256 次读取,全部都映射到了同一个 Set 中!
而这一个 Set 只有 12 个 Way。
256 个数据争抢 12 个位置,导致极其剧烈的 Thrashing(抖动),因此带宽降至最低点。
3. 为什么整体带宽衰减?(TLB Miss)
推测这是 L1 Data TLB 容量不足导致的。
Golden Cove 的 L1 Data TLB 只有 96 个 Entry。
当步长达到 1536 时:
$1536 \times 256 / 4096 = 96$ 个页面。
刚好填满 TLB。继续增加步长,TLB 就会发生 Miss,导致整体带宽下降。
结论:如何推断组相联度?
之所以说这个测试可以推断组相联度,是因为我们可以建立以下关系:
在这个测试中:
- Stride = 256 时发生了性能崩溃。
- 此时使用的 Sets 数量为总 Sets 的 $1/4$。
- 读取次数为 256。
这意味着:
结合总容量公式 $S \times W = 768$ (Cache Lines),代入计算可知,这种情况只会在 $W < 16$ 时发生。这与实际的 12-Way 是吻合的。
虽然这个测试更多是图一乐,不能替代精确的参数查询,但它直观地展示了 Cache Line 冲突 和 Set 映射机制 对程序性能的剧烈影响。