2026.1.26 - 2026.2.1 周报
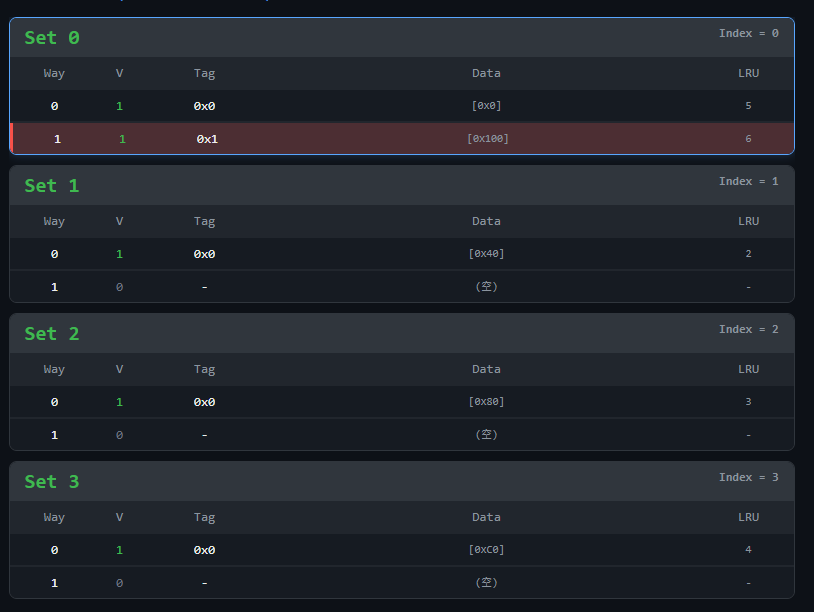
L1 Cache 组相联度探测
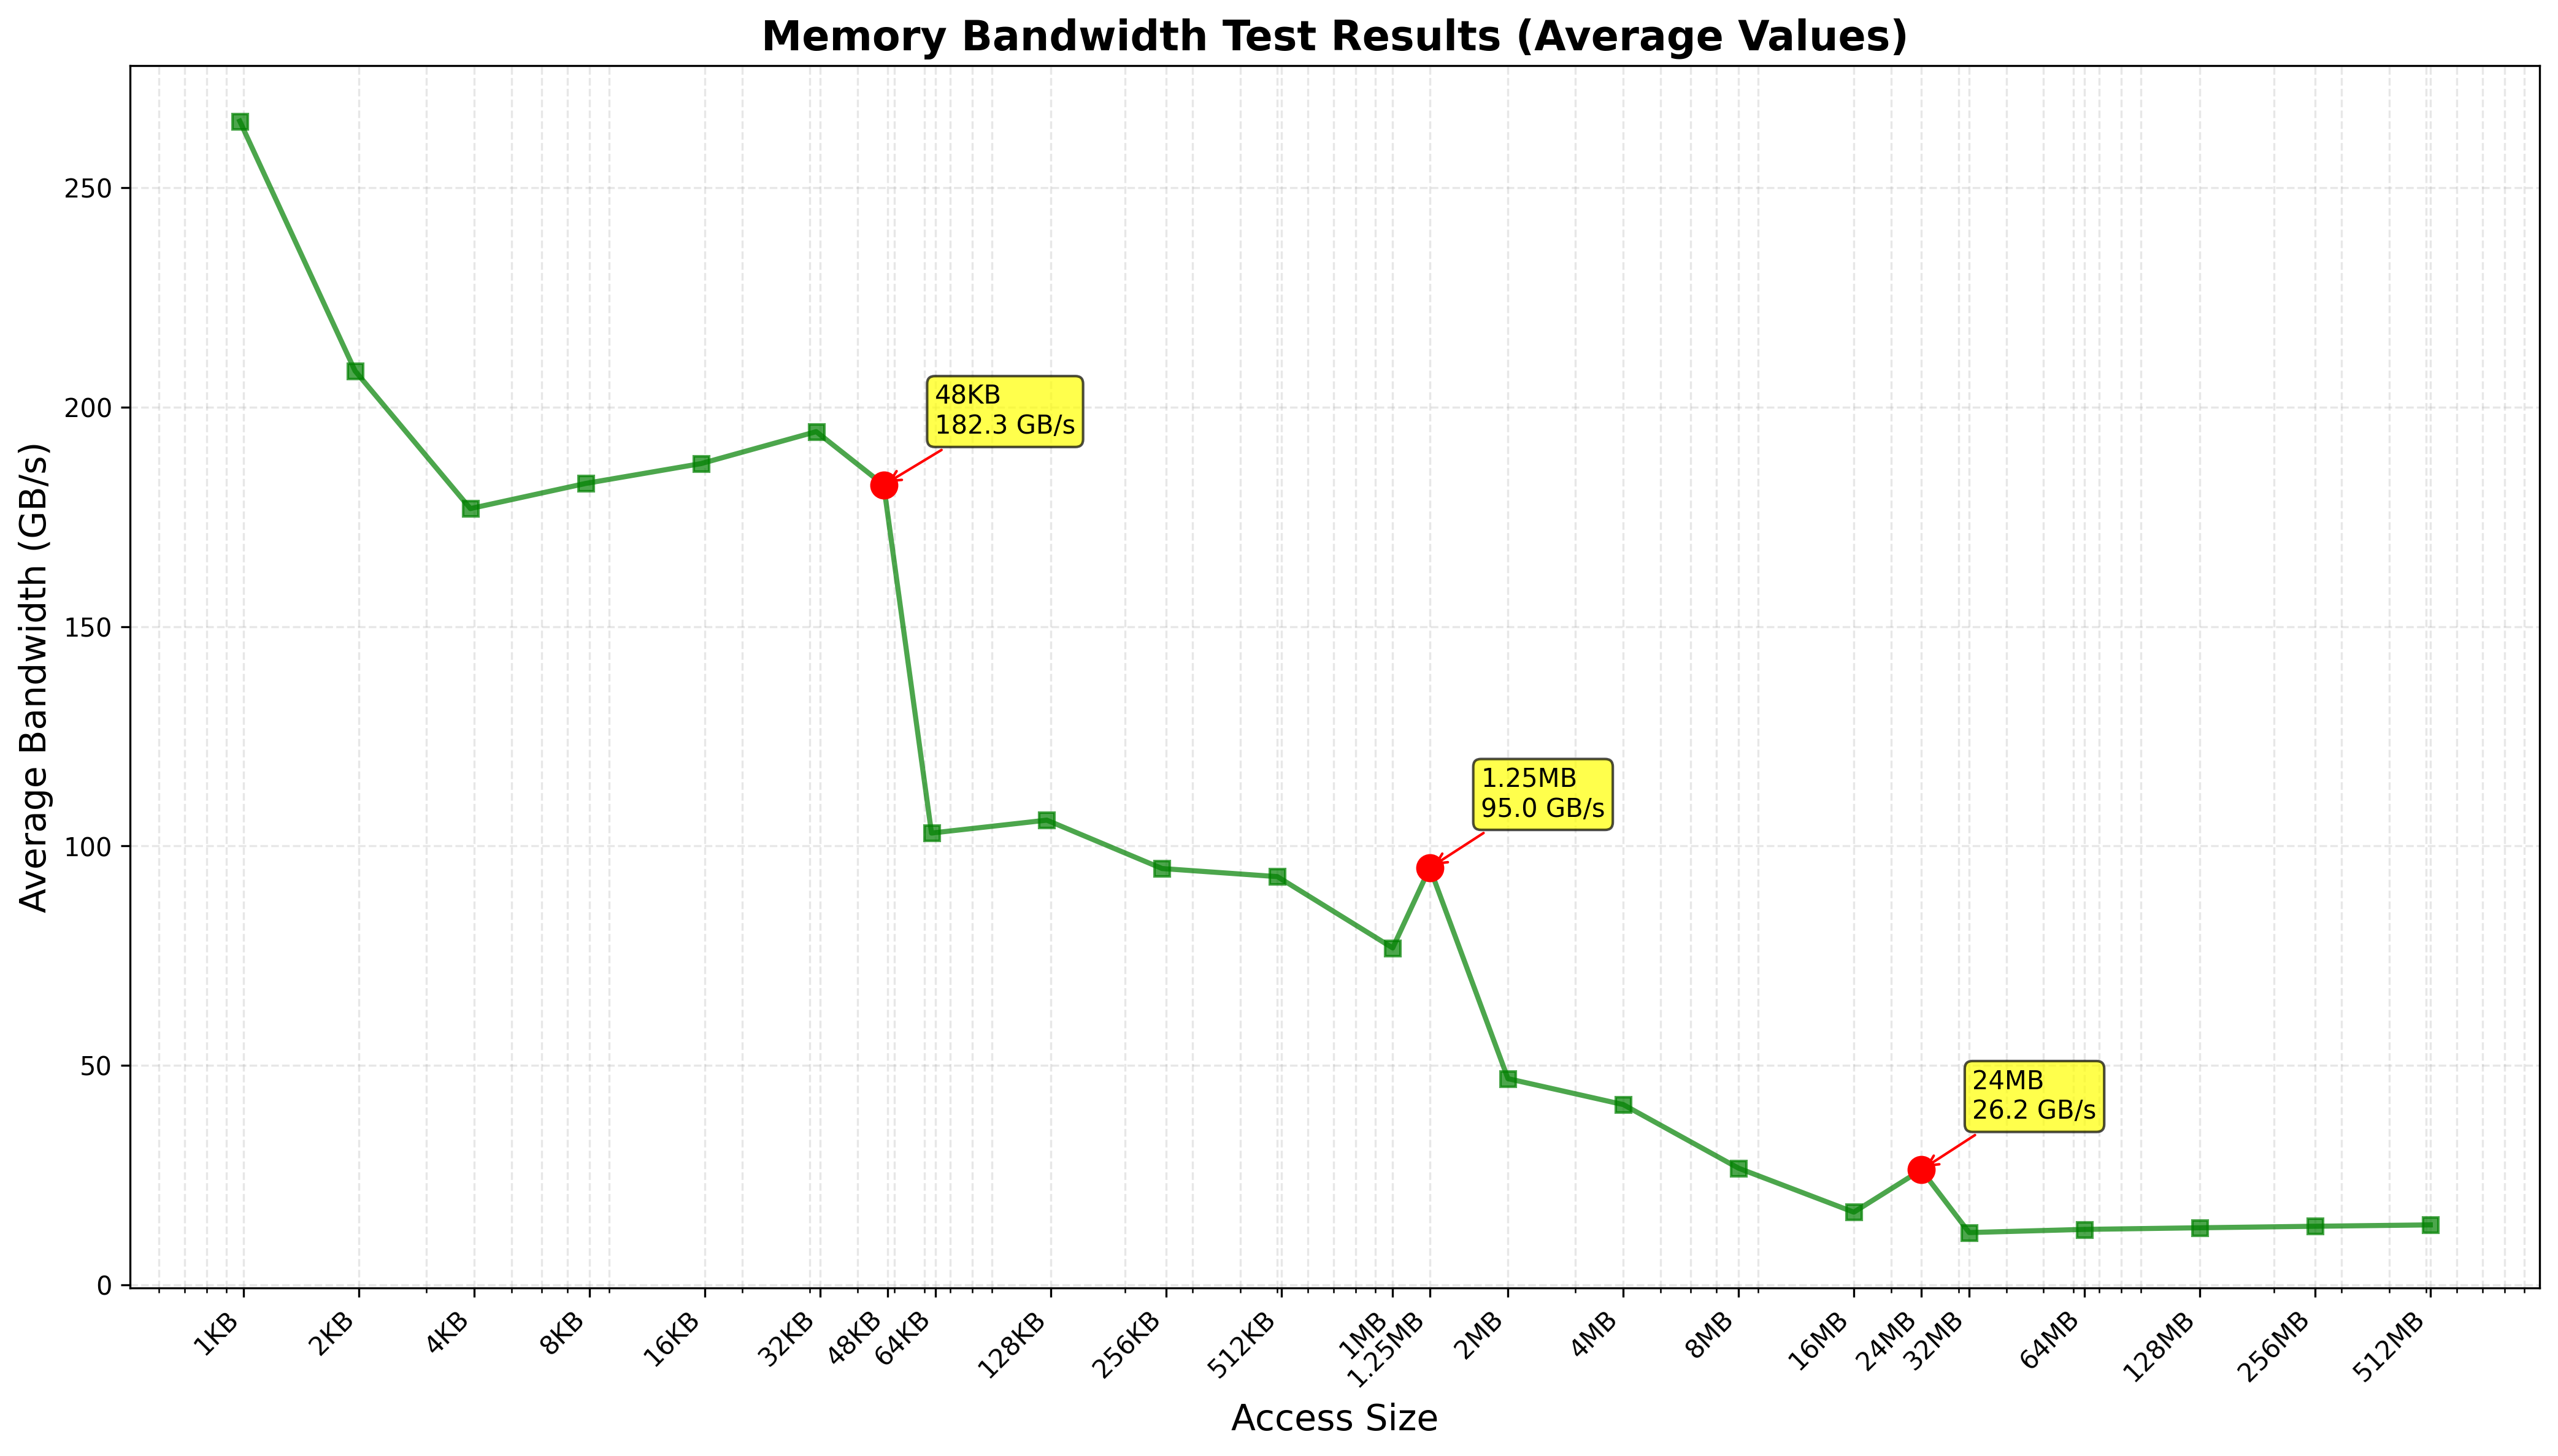
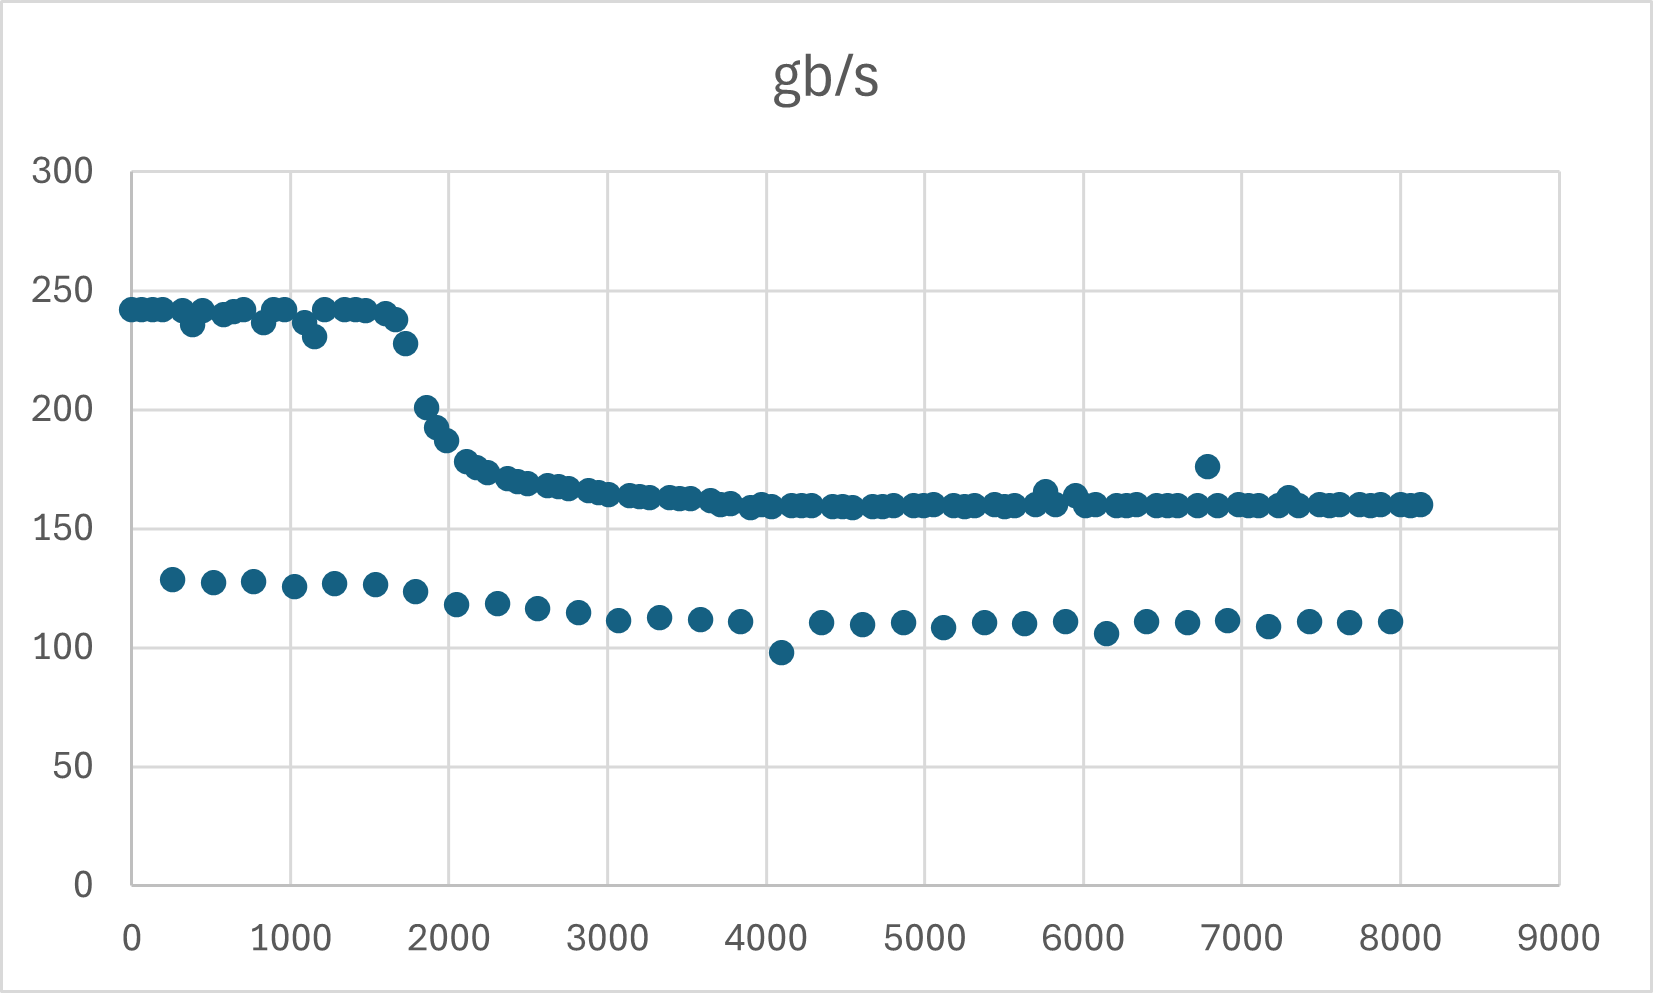
做了一下 L1 Cache 组相联度探测。使用不同的步长访问内存,制造 L1 Cache 冲突,在特定步长下会大幅下降。
主要原因就是:
- 特定步长下降是 Cache 冲突,导致 L1 Cache 不够放了,挤到 L2 了。
- 整体下降是 Data TLB 不够用了,因为到后面步长变大,涉及的页面数变多了。
能用的 Set 数量 = 总 Set 数 / GCD(总 Set 数, stride/64)
- stride = 256 的时候 set 只能用到 1/4
- stride = 4096 的时候,set 只能用到 1/64,所以在这里到达最低点
Softmax 算子的实现及优化
找了一些课程学习了一下 CUDA 编程,主要做了 Softmax 算子的实现及优化。
优化过程为:
1. CPU 实现
代码层面完全串行,只有在 CPU 后端没有依赖链的时候有单核内部的微指令级别的并行。
2. GPU Kernel 1 实现
基本就是原封不动地搬到了 GPU 上,只不过我们给它设置了 N 个线程块,每个线程块一个线程,用 int i = blockIdx.x * blockDim.x + threadIdx.x; 去定位它要修改的数据,也就是它没有最外层的 for 循环了,并行处理每一个向量的数据。
Kernel 1 看似提升了比较大的并行度,但是在 GPU 上,输入张量第二维度上的并行度严重不足,也就是一个向量只由一个线程做处理。
3. GPU Kernel 2 实现
主要做了下面两个优化:
- 使用树形规约大幅增加并行度。一个线程块配置了 512 个线程来并行处理一个向量,每个线程先计算出局部的 max 和 sum,记录在共享内存中,然后再进行规约。
- 规约的数据放在共享内存而不是显存上,共享内存在片上,访问更加快速。
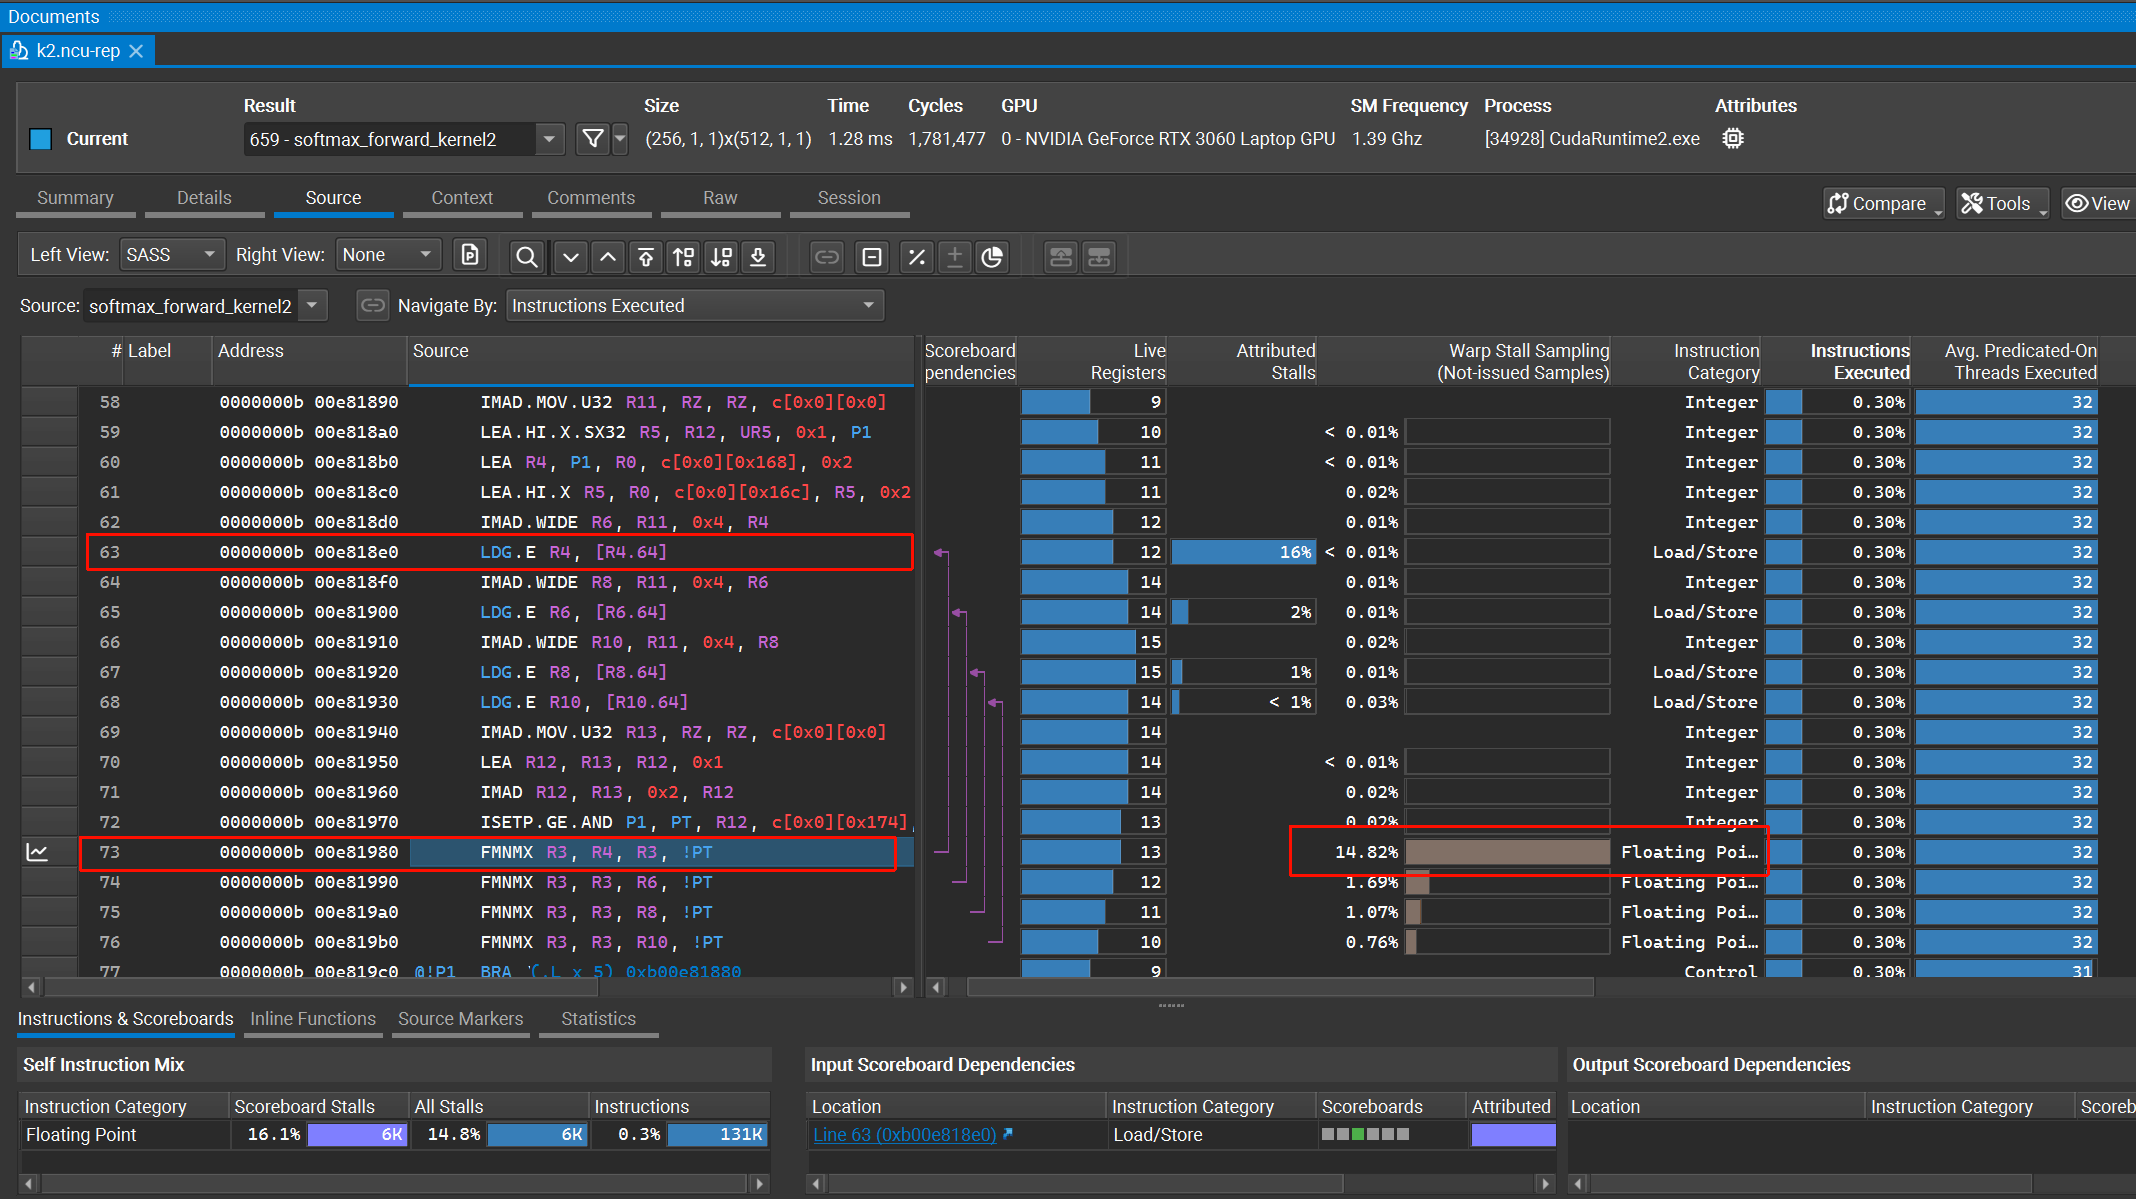
使用 Nsight Compute 针对 Kernel 2 进行分析,每周期平均只有 0.34 个 warp 具备执行条件,主要的阻塞原因是加载存储于全局显存的数据,以及线程之间的同步。
4. GPU Kernel 3 实现
用 Warp Shuffle 指令替换了共享内存通信。但 Shuffle 指令只能在一个 Warp 内起作用,Thread Block 大小不能超过 32,这大大限制了线程块内部的并行潜力。
5. GPU Kernel 4 实现
主要是使用 Warp Shuffle 指令对 GPU Kernel 2 进行优化:
- Kernel 2:每个线程都把自己计算出来的局部最大值写入共享内存,然后进行规约。
- Kernel 4:先使用 Warp Shuffle 在 Warp 内计算出最大值和求和结果,然后再将一个 Warp 的结果写入共享内存进行跨 Warp 规约。
这减少了共享内存的使用,转而使用 Warp 内的寄存器通信。
AI 编程相关
上手了一下 CC / Gemini CLI / Open Code 的 skills、hook、plugins 等功能。
学习了一下 Anthropic Hackathon Winner 的思路:
如何在上下文被压缩的情况下使得大模型最大程度的保持记忆?
通过设置 hook,在大模型每次回答后判断是否达到 10 轮(可配置),如果达到就将这 10 轮的对话总结为 skills。而 skills 是一种逐步披露的 prompt,需要的时候会被大模型看到,而不需要它的时候它不会占用上下文。
这样就达到了让大模型在编码的过程中逐步学习的效果。