CPU 后端端口探测
CPU 后端流水线
在经过取指、解码为 μops、寄存器重命名、分配 ROB 条目后,μops 到达调度器。当数据就绪且执行端口空闲时,它就会被发射到后端的执行单元端口中:
- INT Domain (整数域):ALU 负责加减乘除、位运算、跳转计算
- FLOAT/VEC Domain (浮点/向量域):FPU/SIMD 单元负责浮点运算、AVX/SSE 指令
- MEM Domain (访存域 / AGU):地址生成单元,负责计算
MOV RAX, [RBP+8]中的内存地址
同时还有并行的 LSU(Load/Store Unit),负责 Load/Store 操作,让 MMU 将 AGU 计算出来的地址翻译为物理地址,接着与 Cache/DRAM 交互,进行地址的读取写入。
超标量与端口瓶颈
我们知道现代 CPU 都是 超标量 的,也就是有多条流水线、多执行单元,来实现单核并行。
后端端口的数量是单核并行能力的一个瓶颈,尤其是在计算密集型任务中。
本机配置 i9-12900,分为性能核和能效核,它们分别是:
| 核心类型 | 微架构 | Load 端口 | Store 端口 |
|---|---|---|---|
| 性能核 | Golden Cove | 3 个 | 2 个 |
| 能效核 | Gracemont | 2 个 | 2 个 |
数据来源:
测试方法
可以做一下简单的测试,核心测试代码如下:
Read_x1(1 个 Load)
1 | Read_x1: |
Read_x2(2 个 Load)
1 | Read_x2: |
Read_x3(3 个 Load)
1 | Read_x3: |
Read_x4(4 个 Load)
1 | Read_x4: |
这是一个 循环展开 测试,在展开的每个循环里面有 1/2/3/4 个 Load。根据不同测试下带宽的提升,查看它运行的核上有多少个 Load 端口。
测试结果
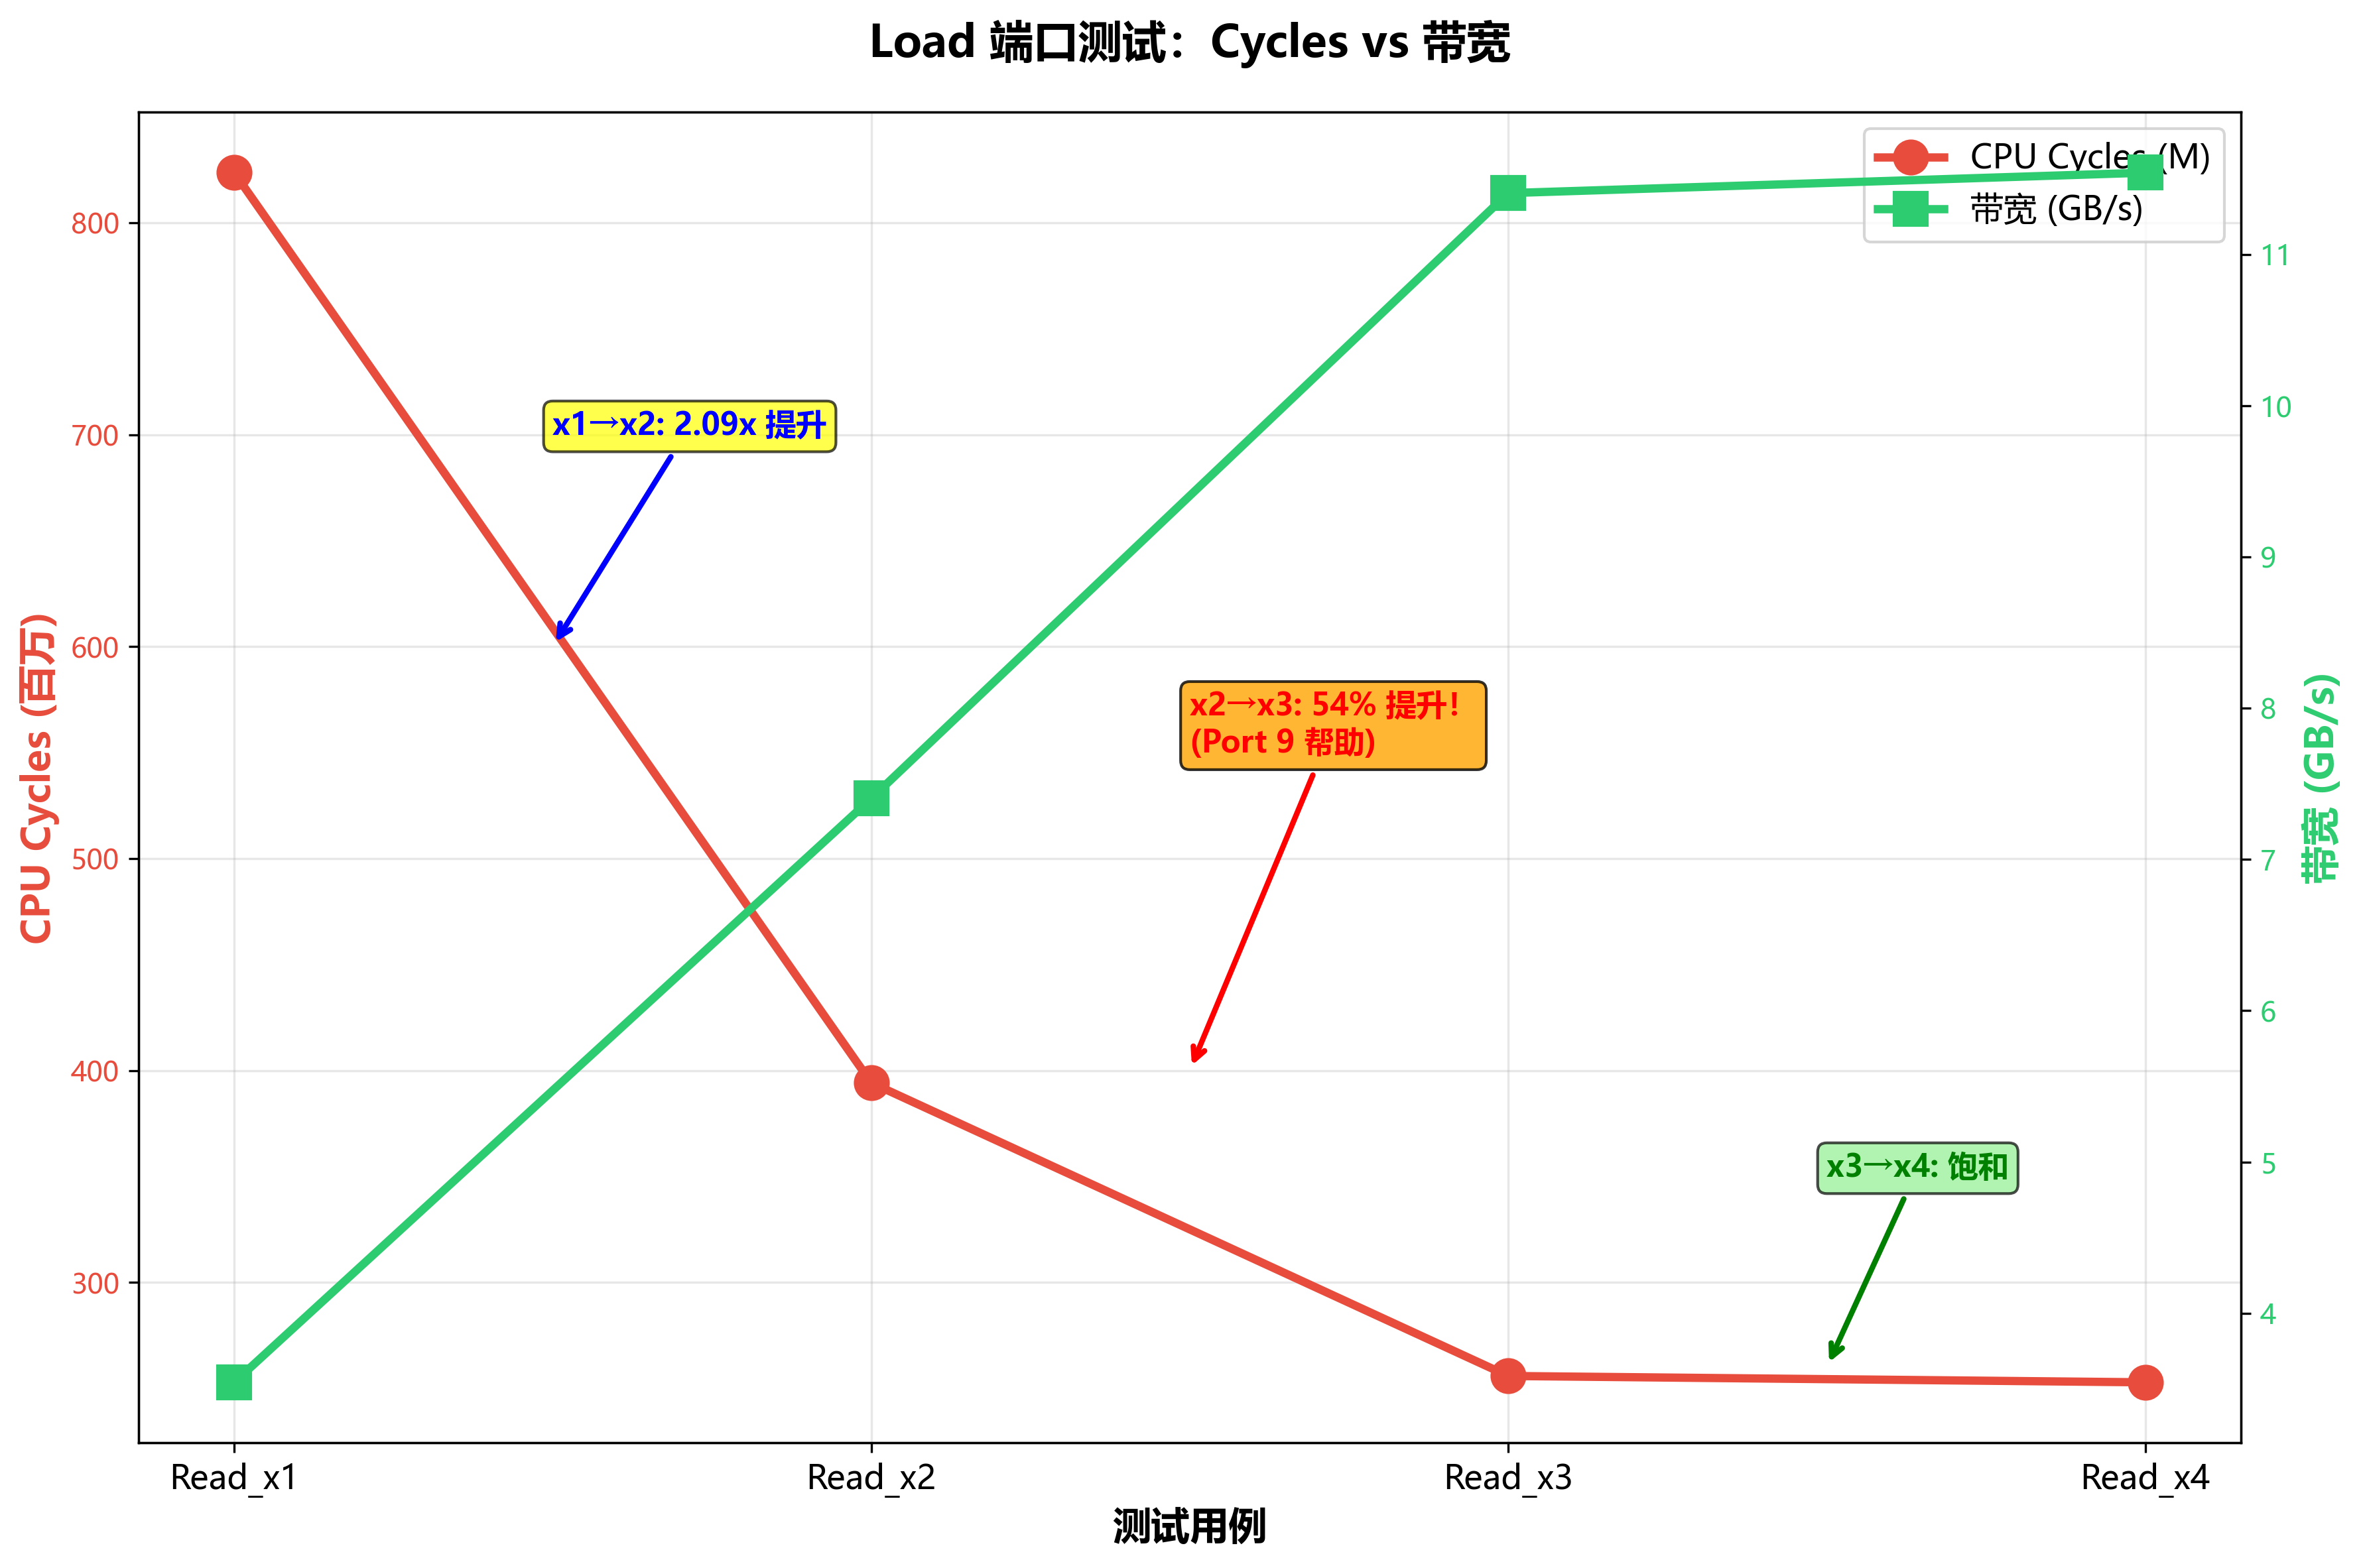
1 | --- Read_x1 --- |
数据分析
根据测试出来的数据可以看到:
- x1 → x2 → x3:基本是线性增长
- x4:趋于平缓
那么它大概率是跑在了 性能核 上(3 个 Load 端口)。
Intel VTune Profiler 验证
使用 Intel VTune Profiler 查看硬件数据。
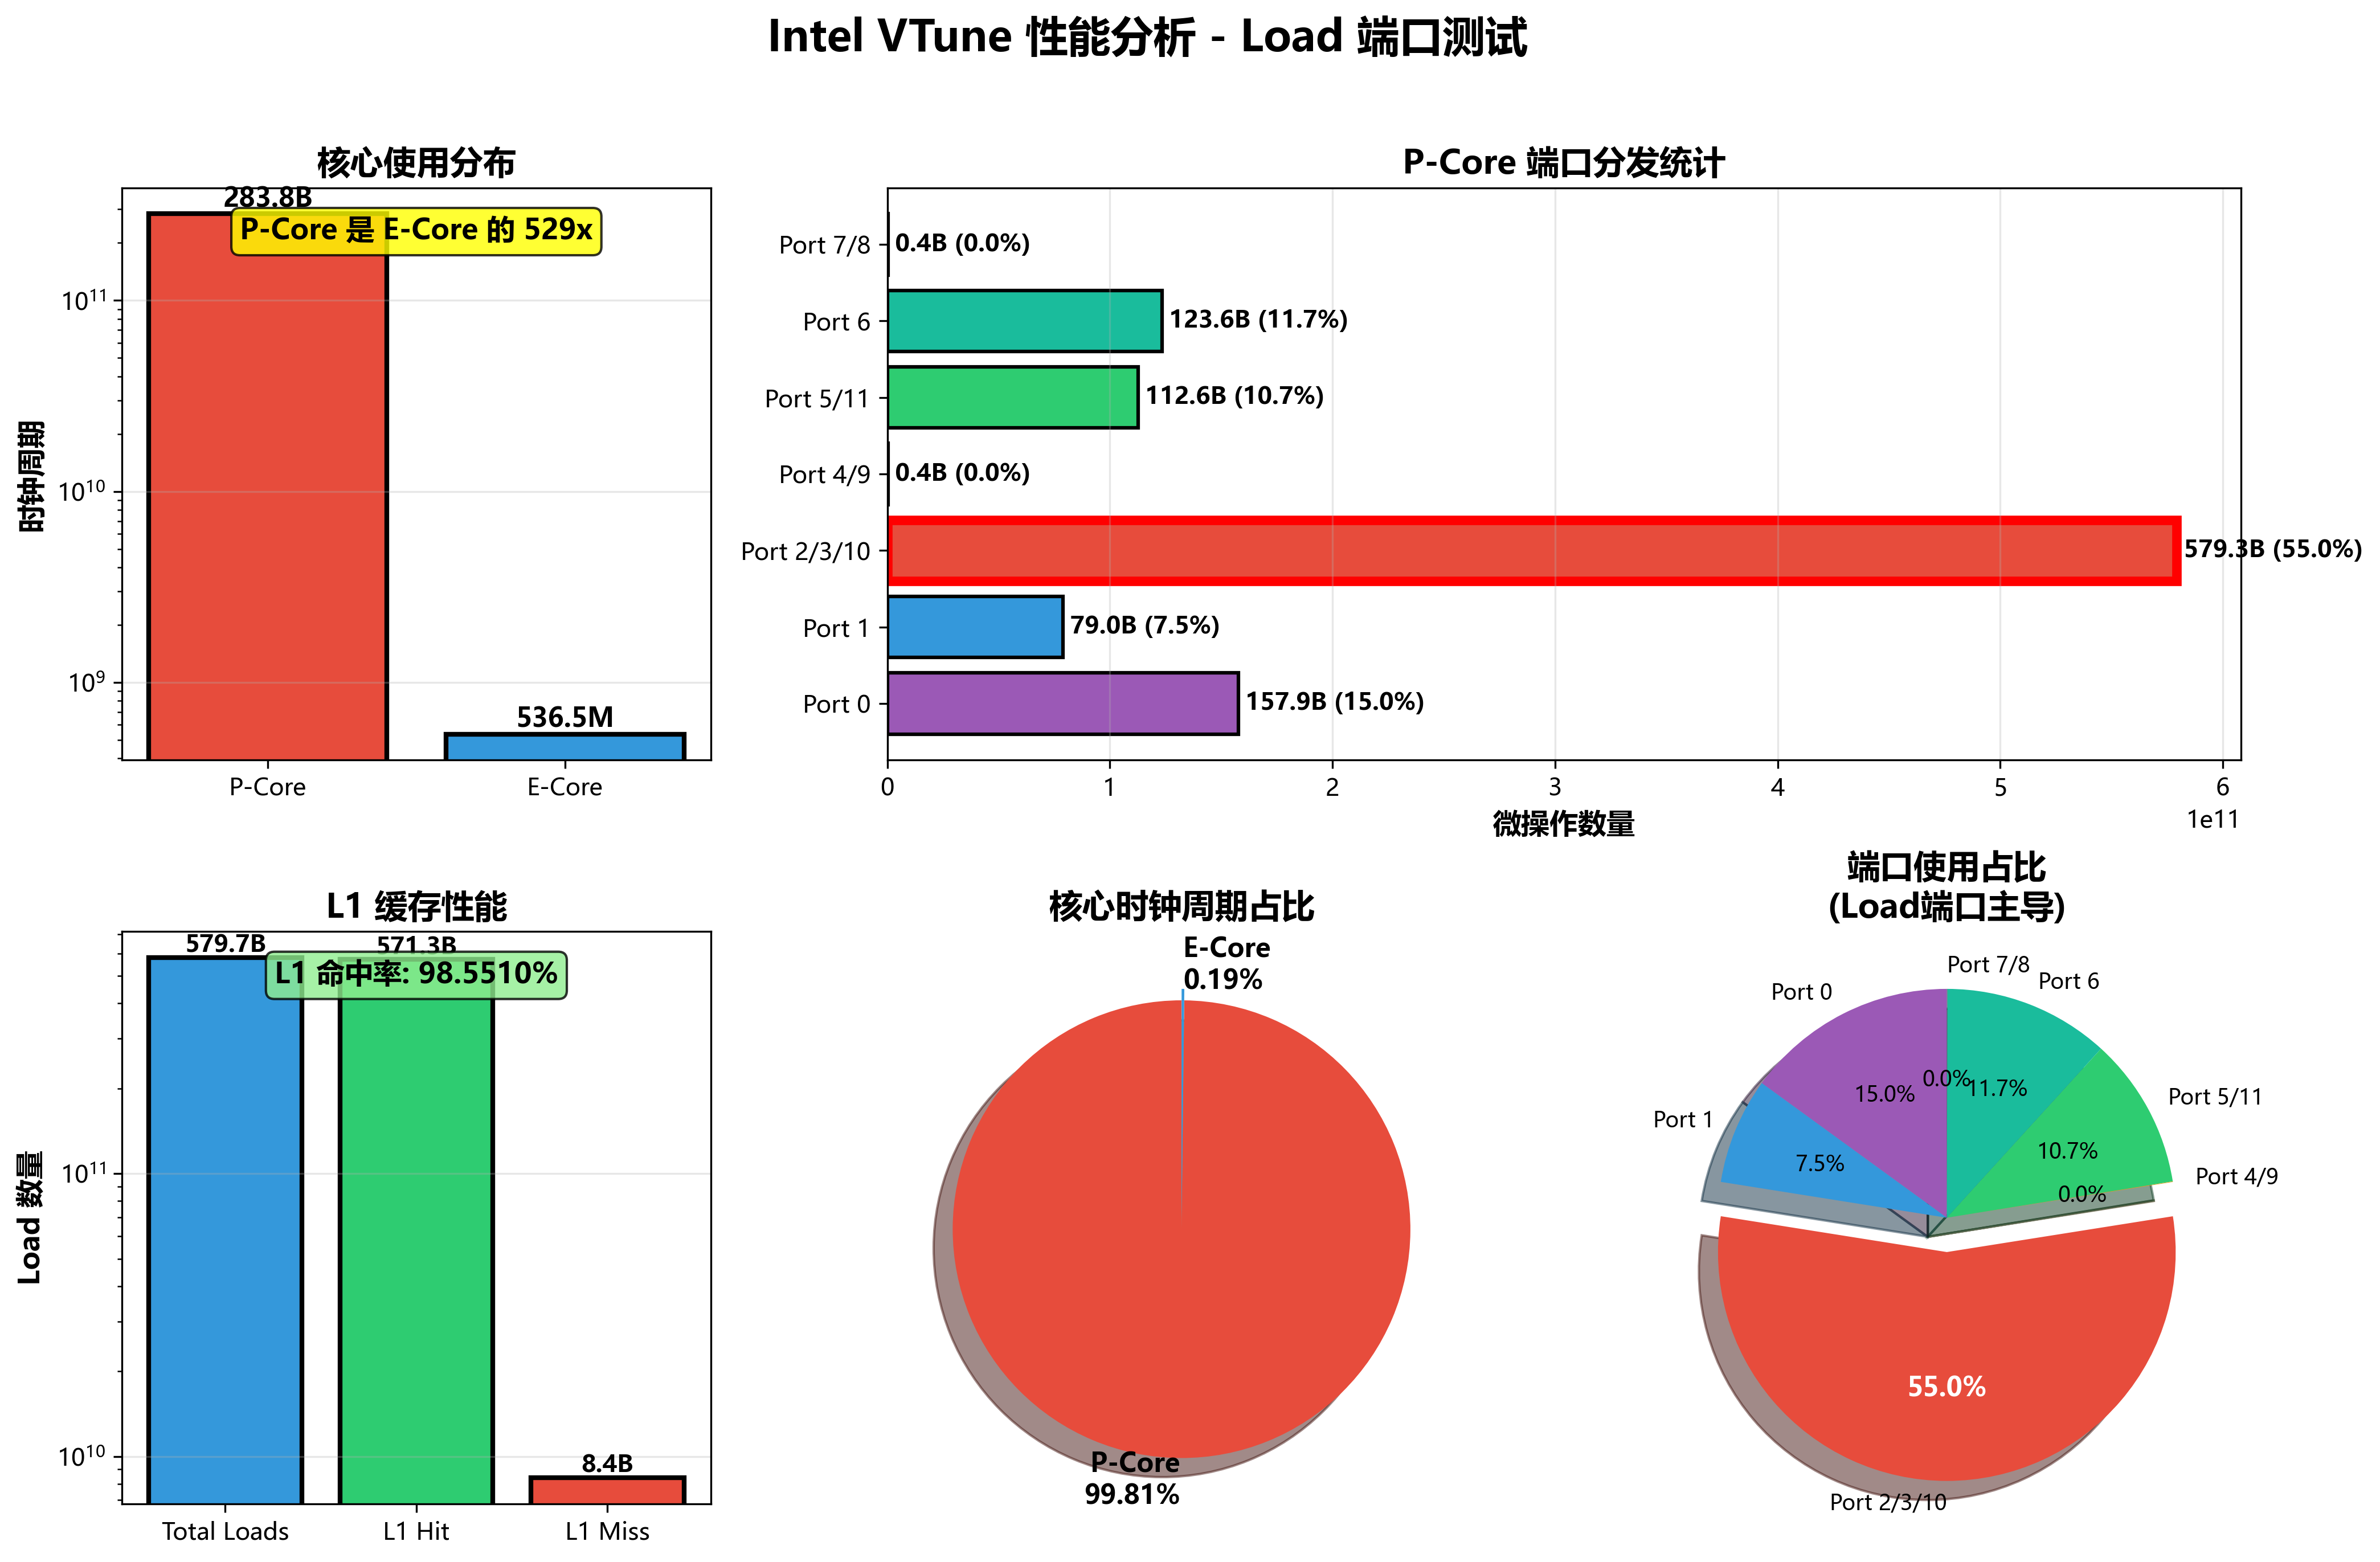
关键硬件事件统计(部分):
| Event | P-Core | E-Core |
|---|---|---|
CPU_CLK_UNHALTED.THREAD |
283,825,900,000 | 536,500,000 |
INST_RETIRED.ANY |
1,575,358,300,000 | 1,745,800,000 |
MEM_INST_RETIRED.ALL_LOADS |
579,727,739,178 | - |
MEM_LOAD_RETIRED.L1_HIT |
571,327,713,978 | - |
UOPS_DISPATCHED.PORT_2_3_10 |
579,306,868,959 | - |
结论
VTune 数据证实了我们的观点:程序 99.81% 运行在 P-Core (Golden Cove)。
从 UOPS_DISPATCHED.PORT_2_3_10 的数据(579B)与 Load 指令数量(579B)高度一致,验证了:
- Golden Cove 的 Port 2/3/10 正是 3 个 Load 端口
- x1 → x3 的线性增长符合 3 端口并行
- x4 时饱和,因为只有 3 个端口可用
All articles on this blog are licensed under CC BY-NC-SA 4.0 unless otherwise stated.
Related Articles
2026-01-22
Pipeline Depth & CPU Frequency
这篇博客简单介绍两个概念:流水线深度 和 频率。 基本概念 流水线深度:一条指令流经 CPU 的过程被切分出来的步骤数量 频率:每秒钟流水线向前推进多少个步骤 现代流水线设计现代教学用的 CPU 模拟器一般是 5 级流水线,比如 gem5 中的一个 CPU 模型:O3CPU - 5 级乱序流水线 1Fetch → Decode → Rename → IEW → Commit 以本机的性能核 Golden Cove(2021 年推出)为例,根据 μops cache 是否命中、指令复杂度等因素,流水线深度在 14~19 级。 历史教训:Pentium 4 的 NetBurst 架构在历史上,CPU 流水线深度并不是稳步增长的。 20 多年前,英特尔曾两次尝试用完全不同的东西来取代其坚固但陈旧的 P6 微架构: 安腾 (Itanium):避免与乱序执行和可变长度解码相关的复杂性,提供非常宽的顺序执行 奔腾 4 (Pentium 4):基于 90nm(”Prescott”)工艺,于 2004 年推出,流水线深度达到了惊人的 31 级 10 GHz 的梦想破灭Pentium 4...
2026-01-27
L1 Cache 组相联度探测
这篇博客主要介绍一种在已知 L1 Data Cache 大小的情况下,探测其 组相联度 (Associativity) 的方法。 背景其实组相联度通常不需要”探测”,因为现代 CPU 为了支持 VIPT (Virtually Indexed, Physically Tagged),通常遵循以下公式: \text{Cache总大小} / \text{组相联度} \leq \text{页大小} (4KB)为了最大化 Cache 容量和 Set 数量,设计时通常取等号。例如,Golden Cove 的 P-Core L1 Data Cache 大小为 48KB。根据公式 $48KB / \text{Ways} = 4KB$,很明显它的组相联度就是 12 路。 关于 VIPT 的详细解释,可以参考我的另一篇博客:Virtually Indexed, Physically Tagged 那么,有没有一种不通过计算,而是通过编写测试代码的方式来探测验证这一结论呢? 答案是有的。这种方法虽然不能给出精确数值,但能通过性能特征推断出大致范围。 探测原理测试方法的核心思想是:制造 Cache...
2026-01-23
L1/2/3缓存探测
又是一篇cpu硬件探测的博客,这篇是探测L1(数据)/2/3缓存。 测试方法采取的方式如下: 每次读取:32 字节(一条 AVX2 指令) 每轮循环:256 字节 测试范围:在指定大小内循环(从1KB到32MB) 总读取量:1GB 核心代码listing_0152_cache_test.asm 1234567891011121314151617181920212223242526272829Read_32x8: xor r9, r9 mov rax, rdx align 64.loop: ; Read 256 bytes vmovdqu ymm0, [rax] vmovdqu ymm0, [rax + 0x20] vmovdqu ymm0, [rax + 0x40] vmovdqu ymm0, [rax + 0x60] vmovdqu ymm0, [rax + 0x80] vmovdqu ymm0, [rax + 0xa0] vmovdqu ymm0, [rax + 0xc0] vmovdqu ymm0,...
2026-01-24
Alignment
这篇博客来聊一个比较重要的概念:对齐 (Alignment)。 在 CPU 执行代码的过程中,一个比较严重的性能瓶颈就是 Back-end Memory Bound(后端访存延迟)。 Intel Haswell 访存延迟参考为了有个大概的概念,我们先看下 Intel Haswell 架构的具体访存延迟数据: 数据来源: 7-cpu.com - Haswell配置: Intel i7-4770 (Haswell), 3.4 GHz, RAM 32 GB (PC3-12800 cl11 cr2) L1 Data cache: 32 KB, 64 B/line, 8-WAY L1 Instruction cache: 32 KB, 64 B/line, 8-WAY L2 cache: 256 KB, 64 B/line, 8-WAY L3 cache: 8 MB, 64 B/line 具体延迟如下: L1 Data Cache Latency: 4 cycles (pointer simple access) 5 cycles (complex address calcula...
2026-01-13
Break the Serial Dependency Chain
本文为学习 Computer Enhance - Instructions Per Clock 的整理。 前情回顾上一篇博客中,我们通过循环展开进行了示例代码的优化,也遇到了串行依赖链的问题。这篇博客就来进一步说明。 之前的优化代码: 123456789101112u32 Unroll4Scalar(u32 Count, u32 *Input){ u32 Sum = 0; for (u32 Index = 0; Index < Count; Index += 4) { Sum += Input[Index]; Sum += Input[Index + 1]; Sum += Input[Index + 2]; Sum += Input[Index + 3]; } return Sum;} 什么是串行依赖链?每个 add 的第一个操作数始终是同一个累加值 Sum。它既是 add 的源,也是其目的地。 这部分代码是一个 串行依赖链:整个求和过程中的每一次...
2025-12-24
Cache
DRAM 读取速度太慢,所以就有了缓存。但同时也引入了缓存抖动、伪共享、读后写、一致性等需要解决的问题,这篇博客中就来介绍下相关的概念。 缓存的种类 L1:指令缓存、数据缓存,核独占 L2:数据指令通用,核独占 L3:核共享 这里以包含式 L3 为例: L3 包含 L1/L2 的所有数据 L3 的目录记录:这行在哪些核的 L1/L2 里 举例:Core 1 想读一个地址: 查 L3 目录 发现 Core 0 有 Modified 副本 通知 Core 0 写回 按照 L1 → L2 → L3 顺序访问,一个 miss 了就下一个,访问速度递减,大小递增。 缓存映射方式缓存映射方式主要有三种: 直接映射(1 路组相联) 组相联 全相联(缓存行数 = 路数) 下面的动画中详细解释: 👉 点击查看组相联缓存动画演示 缓存行置换算法常用的是 Tree PLRU(用二叉树近似 LRU)。为什么不用纯 LRU 呢?是因为硬件成本的问题: 存储缓存行状态需要额外的空间 N 路组相联需要的空间 = log₂(N!) × 组数 = log₂(N!) × (缓存总大小 / 缓存行...