Page Fault Clustering
注意:本文中 Windows 平台的
PageFaultCount使用GetProcessMemoryInfo获取,该字段并不是 Page Fault 进入内核的次数,而是映射的页面数。详见 WRK 源码。在 WRK 中,匿名内存并不会触发聚类,只有文件映射会触发。但在 Win11 10.0.26100 Build 26100 上观测到了匿名内存的类似机制,猜测新版本做了实现。
引言
我们都知道,不管是在 Linux 还是在 Windows,使用 mmap 或 VirtualAlloc 返回的内存只是在 VMA/VAD 上做了记录,并没有被真正分配出来——没有从管理物理页面的结构体中把物理页面拿出来,没有把这个物理页面的 PFN 挂在虚拟地址对应的 PTE 上。这些操作被推迟到 访问这块内存的时候 进行。
但我们思考一个问题:现在的操作系统/编程语言有着各种操作来避免频繁进入内核。例如:
- 操作系统、语言 (Go) 的 堆管理器:后端大量从操作系统批发,切分给前端使用
USER_SHARED_DATA:同一个物理内存映射在内核空间和用户空间,使得可以不进入内核就获取系统信息
我们可以推测出 进入内核的开销并不小。那么在缺页异常中呢?是否会有一种机制,使得用户访问一块地址后,为了减少进入内核的次数,一次性映射多个页面?
答案是 有的,并且在不同的操作系统中有着不同的实现。
测试代码
测试代码位于 computer_enhance 的 listing_108 和 listing_0112 到 listing_0115。
代码功能总结
| 文件 | 功能 |
|---|---|
listing_0112 |
正向触碰:从头到尾(0 → End)一页一页写入,观察缺页分配行为 |
listing_0113 |
反向触碰:从尾到头(End → 0)倒着写,观察预映射是否失效 |
listing_0114 |
反向测试封装:将反向写入封装成测试函数,供性能测试器调用 |
listing_0115 |
全面性能测试:对比正向和反向写入的速度 |
ReadOSPageFaultCount 的实现
这个函数负责读取操作系统记录的”缺页计数”,实现位于 listing_0108_platform_metrics.cpp。
Windows 平台:
- API:
GetProcessMemoryInfo(来自<psapi.h>) - 读取字段:
PROCESS_MEMORY_COUNTERS_EX.PageFaultCount - 含义: 进程自启动以来,发生的 页面映射总数(包含 OS 批量预映射的数量)
Linux / macOS 平台:
- API:
getrusage - 读取字段:
ru_minflt(软缺页) +ru_majflt(硬缺页)
Windows 测试结果
以下测试结果来自 Win11 10.0.26100 Build 26100。在 Win10 1703 上测试并没有出现 Page Fault Clustering 优化,可能是内核配置差异。
正向访问(2048 页)
局部图: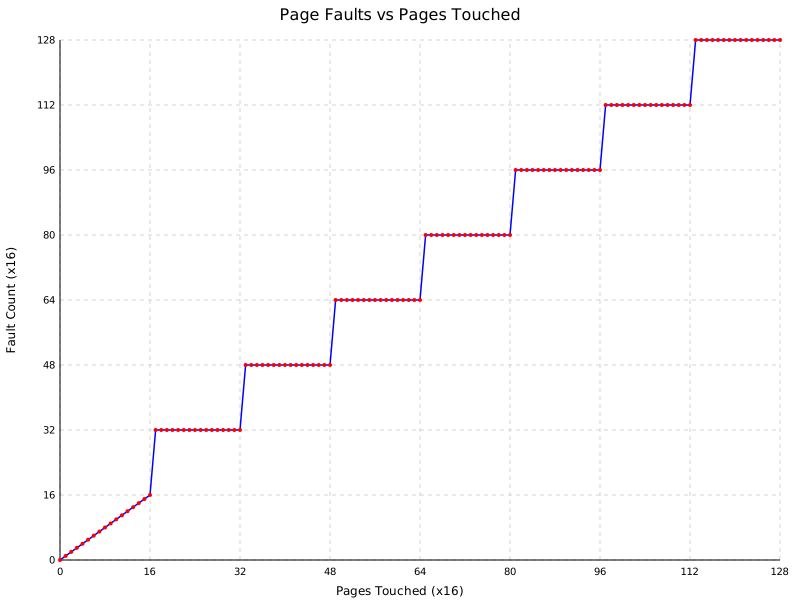
全局图: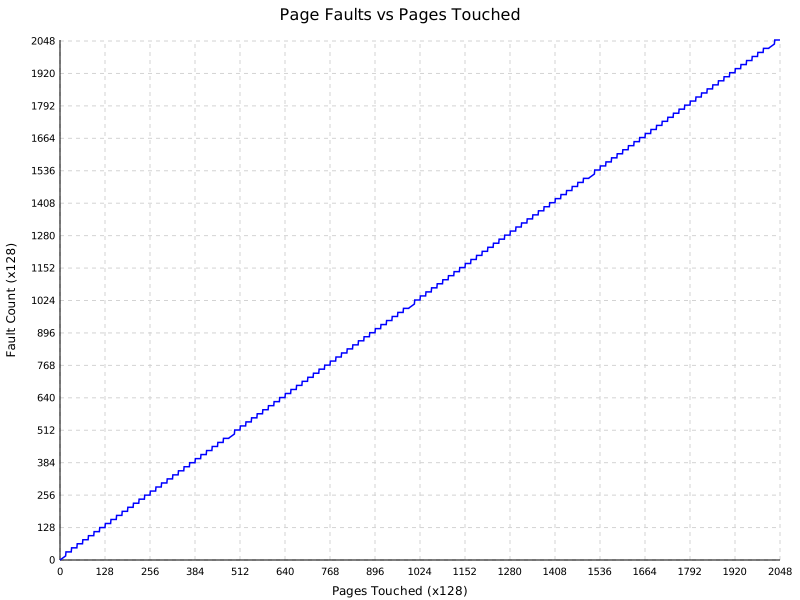
具体数据:
| Page Count | Touch Count | Fault Count | Extra Faults |
|---|---|---|---|
| 32 | 0 | 0 | 0 |
| 32 | 1 | 1 | 0 |
| 32 | 2 | 2 | 0 |
| 32 | 3 | 3 | 0 |
| 32 | 4 | 4 | 0 |
| 32 | 5 | 5 | 0 |
| 32 | 6 | 6 | 0 |
| 32 | 7 | 7 | 0 |
| 32 | 8 | 8 | 0 |
| 32 | 9 | 9 | 0 |
| 32 | 10 | 10 | 0 |
| 32 | 11 | 11 | 0 |
| 32 | 12 | 12 | 0 |
| 32 | 13 | 13 | 0 |
| 32 | 14 | 14 | 0 |
| 32 | 15 | 15 | 0 |
| 32 | 16 | 16 | 0 |
| 32 | 17 | 32 | 15 |
| 32 | 18 | 32 | 14 |
| 32 | 19 | 32 | 13 |
| 32 | 20 | 32 | 12 |
| 32 | 21 | 32 | 11 |
| 32 | 22 | 32 | 10 |
| 32 | 23 | 32 | 9 |
| 32 | 24 | 32 | 8 |
| 32 | 25 | 32 | 7 |
| 32 | 26 | 32 | 6 |
| 32 | 27 | 32 | 5 |
| 32 | 28 | 32 | 4 |
| 32 | 29 | 32 | 3 |
| 32 | 30 | 32 | 2 |
| 32 | 31 | 32 | 1 |
| 32 | 32 | 32 | 0 |
可以看到,这个图并不是一条直线,而是 阶梯形 的。数据中出现了 单位为 16 的跳跃,说明存在一种”预分配”机制。
Windows 页面错误聚类(Page Fault Clustering)
查看 WRK 源码后,找到了这个机制:Page Fault Clustering。
页面错误聚类是 Windows 内存管理器的一项优化技术:当发生页面错误时,不仅读入导致错误的页面,还会 预读取相邻的页面,以减少未来的页面错误次数。
这是一个 线程级别 的配置,在每个线程的 ETHREAD 中有如下字段:
1 | ULONG ReadClusterSize; // 每次页面错误时预读的页面数量 |
ReadClusterSize 的初始化(根据物理内存大小):
| 物理内存 | ReadClusterSize |
|---|---|
| ≤ 13MB | 2 页 |
| 13MB - 19MB | 4 页 |
| > 19MB | 7 页 |
注:Win11 实测观察到 16 页 的聚类跳跃,与 WRK 的默认值(7 页)不同,可能是新版本调整了参数或针对匿名内存做了不同实现。
为什么每 512 页产生额外页面错误?
在 pagfault.c 第 2670 行左右,聚类计算基于页表内的位置:
1 | MaxForwardPageCount = PTE_PER_PAGE - (BYTE_OFFSET(PointerPte) / sizeof(MMPTE)); |
其中 PTE_PER_PAGE = 512(4096 字节页表 ÷ 8 字节 PTE = 512 个条目)。
当触摸 512 个页面后,一个页表被填满,Windows 必须分配新的物理页面来存储下一个页表。Windows 的页面错误计数器将这个 页表页面的映射也计为”页面错误”,所以每 512 个用户页面就会看到 1 个额外的页面错误。
为什么预映射在页表边界停止?
在 pagfault.c 第 3926 行,向前聚类的核心循环:
1 | while ((MiIsPteOnPdeBoundary(CheckPte) == 0) && // 关键检查! |
MiIsPteOnPdeBoundary 宏检查 PTE 地址是否对齐到 4KB 边界。当 PTE 索引从 511 回绕到 0 时,循环立即终止。
Windows 故意设计成不跨越页表边界进行聚类,这是为了:
- 避免跨页表的额外复杂度
- 保持局部性原理(同一页表内的页面更可能连续访问)
- 限制预取范围,避免过度消耗内存
反向访问(2048 页)
局部图: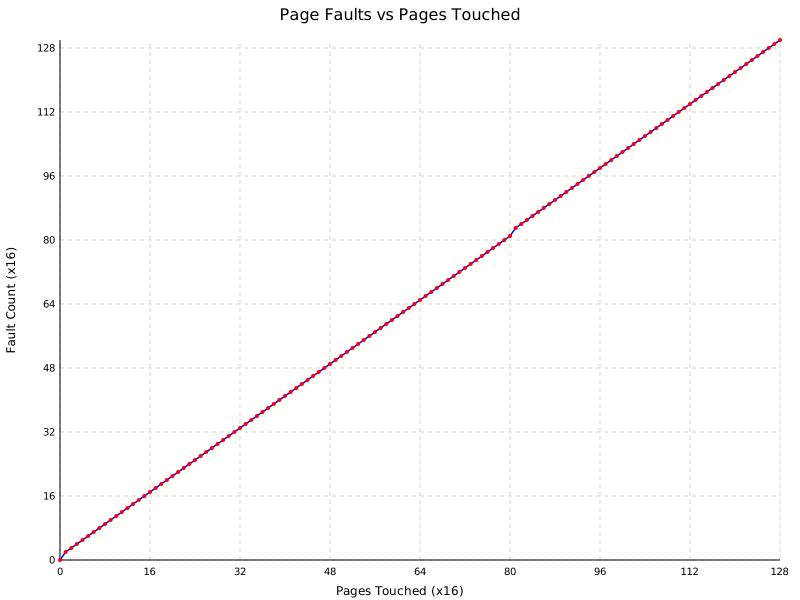
全局图: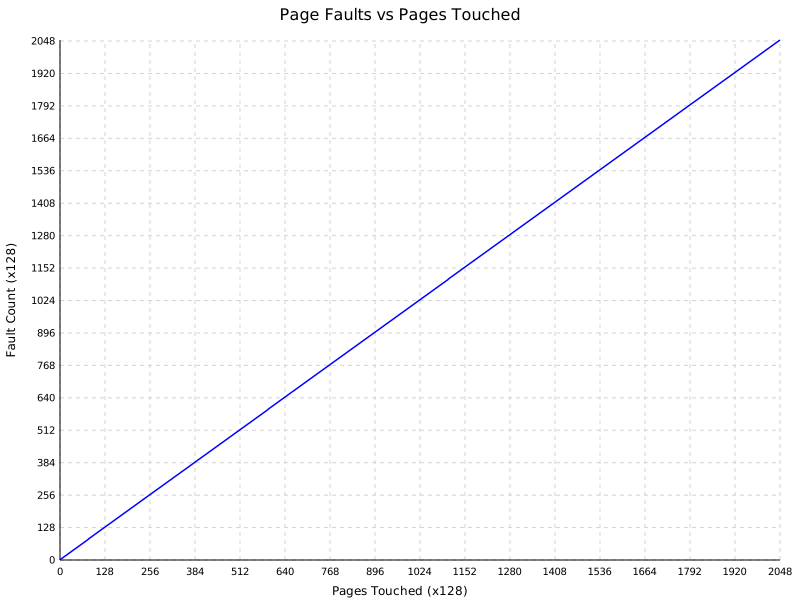
具体数据:
| Page Count | Touch Count | Fault Count | Extra Faults |
|---|---|---|---|
| 32 | 0 | 0 | 0 |
| 32 | 1 | 1 | 0 |
| 32 | 2 | 2 | 0 |
| 32 | 3 | 3 | 0 |
| 32 | 4 | 4 | 0 |
| 32 | 5 | 5 | 0 |
| 32 | 6 | 6 | 0 |
| 32 | 7 | 7 | 0 |
| 32 | 8 | 8 | 0 |
| 32 | 9 | 9 | 0 |
| 32 | 10 | 10 | 0 |
| 32 | 11 | 11 | 0 |
| 32 | 12 | 12 | 0 |
| 32 | 13 | 13 | 0 |
| 32 | 14 | 14 | 0 |
| 32 | 15 | 15 | 0 |
| 32 | 16 | 16 | 0 |
| 32 | 17 | 17 | 0 |
| 32 | 18 | 18 | 0 |
| 32 | 19 | 19 | 0 |
| 32 | 20 | 20 | 0 |
| 32 | 21 | 21 | 0 |
| 32 | 22 | 22 | 0 |
| 32 | 23 | 23 | 0 |
| 32 | 24 | 24 | 0 |
| 32 | 25 | 25 | 0 |
| 32 | 26 | 26 | 0 |
| 32 | 27 | 27 | 0 |
| 32 | 28 | 28 | 0 |
| 32 | 29 | 29 | 0 |
| 32 | 30 | 30 | 0 |
| 32 | 31 | 31 | 0 |
| 32 | 32 | 32 | 0 |
反向访问基本是完全的直线(每次访问都触发一次映射),除了在 PTE 用完时分配新页表会多出一个。
这说明当前 Windows 内核版本下,当前进程被判断为 只需要向前(小地址方向)聚类。
综合性能测试
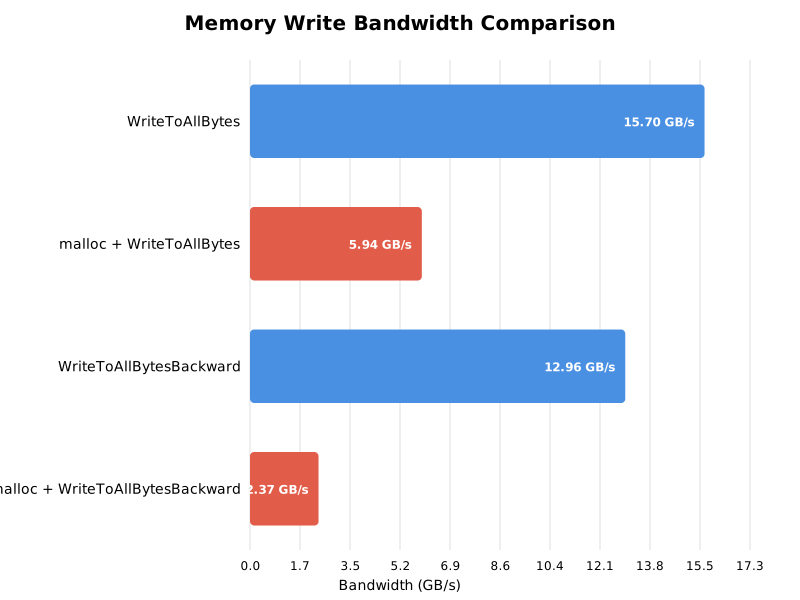
- 带
malloc的是每次都新分配内存 - 不带的是空间复用
可以看到预取对于 正向访问的大幅优化。
Linux 的类似机制
在 Linux 中存在一些类似的机制:
1. Fault Around(文件映射预映射)
这是最接近 Windows Page Fault Clustering 的机制。
位置:mm/memory.c 第 5507-5537 行
仅针对文件映射。
1 | /* |
2. Swap Readahead(换入预读)
当从 swap 换入页面时,Linux 会预读相邻的页面。
位置:mm/swap_state.c 第 567-637 行
1 | /** |
3. 透明大页(THP)的匿名页面优化
对于匿名页面,Linux 使用 透明大页 而非 fault around 来减少缺页次数。
位置:mm/memory.c 第 4915-4998 行
1 | static struct folio *alloc_anon_folio(struct vm_fault *vmf) |
如果启用了 THP,一次匿名页面缺页可能会分配 2MB(512 页) 的大页,远超 Windows 的 16 页聚类。